 ChatGPT
 Claude
 Mode IA
 Perplexity

Depuis quelques années, l’intelligence artificielle, en plein essor, est devenue accessible à tout le monde. Mais derrière les modèles IA qui donnent des réponses et qui génèrent des images ou des vidéos se cache un véritable écosystème d’infrastructure qui les fait fonctionner. En effet, le passage d’un prototype d’intelligence artificielle fonctionnel sur un environnement local nécessite un service robuste accessible en production, des compétences techniques avancées et des outils adaptés.
C’est là qu’intervient Baseten, une plateforme spécialisée dans l’inférence c’est-à-dire la capacité à exécuter des modèles IA sur les machines des utilisateurs dans des conditions réelles. Baseten permet alors aux entreprises et des développeurs de déployer leur modèle IA et de le rendre accessible via des API sans avoir à gérer la complexité de l’infrastructure Cloud.
Mais alors, comment industrialiser son modèle avec Baseten ? Pour le savoir, notre agence IA DigitalUnicorn vous présente les étapes clés pour déployer un modèle IA en production avec Baseten incluant la préparation du modèle jusqu’à l’optimisation des performances.
Qu’est-ce que Baseten ?
Baseten est une plateforme de service et d’infrastructure Cloud spécialisée dans le déploiement, l’hébergement et l’exécution des modèles d’intelligence artificielle en production. A la différence des solutions Cloud généralistes où les clients doivent tout configurer manuellement, Baseten offre déjà une couche d’abstraction dédiée pour l’inférence. En d’autres termes, elle transforme un modèle déjà entraîné en un service capable de traiter des requêtes venant d’applications web ou mobiles ou d’autres systèmes informatiques.
Baseten prend en charge plusieurs étapes dans le déploiement, dont la préparation de l’environnement, le déploiement du modèle, l’allocation des ressources et la création de points de terminaison API pour l’accès à l’IA.
Pourquoi choisir Baseten pour le déploiement de modèles d’IA ?
Baseten est très intéressant d’un point de vue technique et économique. Les équipes peuvent se concentrer davantage sur le développement de leur modèle et de ses fonctionnalités, vu que la maintenance de toute l’infrastructure dédiée est à la charge de Baseten. En effet, le déploiement de l’IA ne se limite pas à mettre des fichiers sur un serveur ; il faut aussi prendre en compte le temps de réponse et les ressources requises par rapport au volume de requêtes.
Les développeurs et les entreprises peuvent alors éviter la gestion des ressources CPU et GPU, la configuration de l’infrastructure et l’optimisation de l’inférence. S’adressant plutôt aux modèles de langage LLM, de génération d’images ou de reconnaissance vocale, Baseten s’appuie sur Truss, l’un de ses principaux outils, une bibliothèque open source qui facilite la création de l’environnement regroupant le code, les dépendances et les paramètres.
Les avantages sont alors :
- La simplification du déploiement des modèles avec Truss;
- L’accès à une infrastructure GPU adaptée aux ressources nécessaires ;
- L’amélioration des performances d’inférence en optimisant le GPU, la gestion de requêtes simultanées et le temps de traitement grâce à des moteurs d’inférence optimisés ;
- La facilité d’intégration avec les applications web ou mobiles grâce à la création de points de terminaison API.
Vous avez un modèle d’IA performant, mais vous ne savez pas comment l’exploiter à grande échelle ? Faites appel à DigitalUnicorn pour concevoir une application capable de tirer pleinement parti de vos technologies IA et d’offrir une expérience fluide à vos utilisateurs.
Préparer votre modèle pour la mise en production
Si vous avez bien compris, le déploiement d’un modèle IA avec Baseten nécessite une préparation minutieuse de son modèle et de son environnement. Cette première étape permet d’assurer que le modèle dispose de tous les éléments nécessaires à son exécution et reproduira fidèlement le test de développement.
Utiliser Truss pour packager votre environnement
Pour la préparation, Baseten utilise Truss pour le packaging de votre environnement. Cet outil open source permet de réduire les manipulations techniques liées à la conteneurisation où les développeurs n’ont pas besoin de configurer une infrastructure Docker et chaque composant d’un serveur.
Pour ce faire, vous devez disposer d’un environnement Python avant d’installer Truss avec la commande pip install –upgrade truss. Ensuite, vous devez vous authentifier auprès de Baseten sur un navigateur ou via une clé API trouvée dans le compte Baseten. La prochaine étape consiste à créer et à structurer le projet Truss avec :
- Config.yaml: c’est le fichier central qui définit les paramètres du modèle, les ressources matérielles requises et l’environnement d’exécution ;
- Model/: le répertoire pour héberger le code Python du modèle sur les opérations de prétraitement, d’inférence et de post-traitement ;
- Les autres fichiers de configuration: pour organiser les dépendances et les autres éléments.
La préparation du projet dépend du type de modèle et du moteur d’inférence utilisé.
Gérer les dépendances et les poids du modèle
Un modèle d’intelligence artificielle ne fonctionne jamais seul. Il dépend aussi de plusieurs bibliothèques, de certaines versions de Python et parfois de quelques composants du système. Une mauvaise gestion de ces dépendances peut alors dégrader la qualité de l’IA ou même perturber son bon fonctionnement.
Il faut donc identifier et déclarer ces dépendances qui peuvent être PyTorch, Transformers, Diffusers, NumPy ou encore des bibliothèques spécialisées dans le traitement des données selon le projet. Dans Truss, les dépendances sont inclues dans le fichier central Config.yaml.
Ensuite, la taille ou le poids du modèle doit aussi être pris en compte, car ils peuvent représenter plusieurs gigaoctets, voire plus pour des grands modèles de langage. En fait, le poids est constitué des fichiers comprenant les paramètres appris pendant l’entraînement. Pour l’intégrer efficacement à l’environnement, il existe plusieurs manières différentes, comme :
- Hugging Face: récupérer le poids directement sur un dépôt public ou privé ;
- Stockage Cloud: télécharger les fichiers depuis un espace de stockage Cloud ;
- Environnement local: intégrer les fichiers disponibles sur la machine ;
- URL : récupérer les fichiers depuis une source disponible au moment de la préparation du modèle.
Enfin, les développeurs doivent vérifier si le poids du modèle, les frameworks utilisés, le moteur d’inférence ou les ressources GPU sont compatibles avant de finaliser la préparation.
Votre modèle IA est prêt, mais son environnement nécessite encore quelques ajustements avant le déploiement et l’intégration dans les applications ? Notre agence mobile DigitalUnicorn vous accompagne dans la préparation technique, l’intégration des dépendances et le développement de votre solution pour garantir une mise en production fiable et performante.
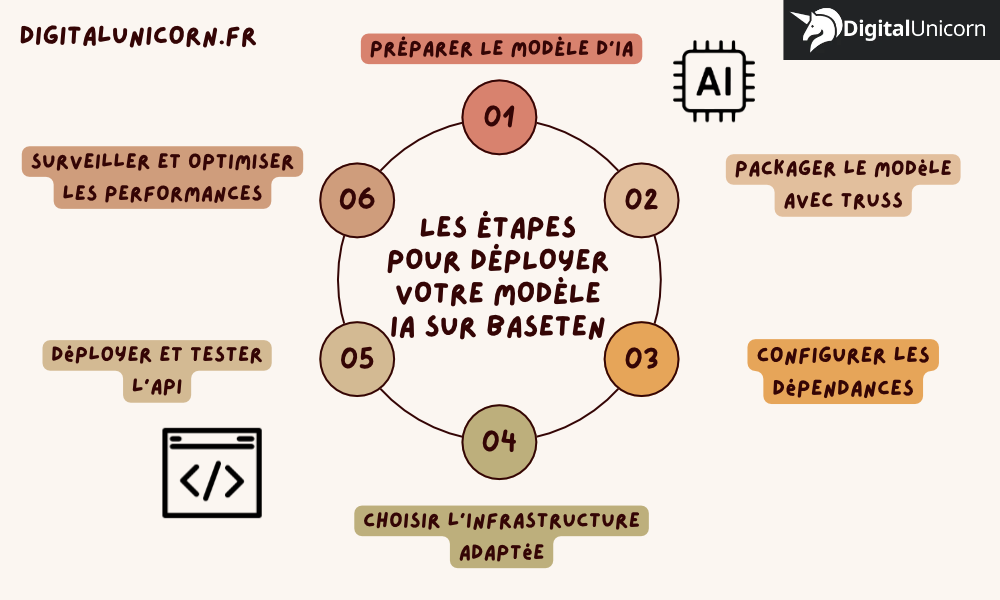
Étape par étape : déployer votre modèle sur Baseten
Après le packaging de votre modèle et de l’environnement, le déploiement peut commencer. Le processus consiste à envoyer le modèle vers la plateforme Baseten tout en construisant l’environnement d’exécution et le rendre accessible depuis un serveur distant.
Configuration de l’infrastructure de service
La configuration de l’infrastructure permet de déterminer les ressources nécessaires pour exécuter le modèle dans des conditions réelles. Elle doit être adaptée au poids du modèle, à son architecture et au volume des requêtes attendu. Comme nous l’avons vu, le fichier Config.yaml de Truss définit les ressources matérielles et les paramètres de déploiement. Voici un exemple de configuration :
- Le modèle de langage : Qwen 2.5 3B ;
- L’accélérateur graphique ou le GPU : NVIDIA L4 ;
- Le moteur d’inférence : TensorRT-LLM ;
- La source où l’infrastructure récupère le poids du modèle : poids local ;
- La longueur maximale de séquence en prise de charge : 8192 ;
- La méthode de quantification pour optimiser la représentation du poids : fp8 ;
- Le nombre de GPU pour repartir le calcul du modèle pendant l’inférence : 1 ;
- Le nombre de GPU utilisé pendant la phase de construction du moteur : 2.
Une fois le fichier configuré, le développeur peut transférer son projet sur Baseten avec la commande uvx truss push. La plateforme prépare alors l’environnement, construit le conteneur nécessaire et déploie le modèle avec les ressources sélectionnées.
Création et test de votre point de terminaison API
Après le déploiement, Baseten doit d’abord créer un point de terminaison API qui sert d’interface entre le modèle IA et les applications qui veulent l’intégrer. Chaque modèle, dans Baseten, possède un identifiant unique qui permet de retrouver son adresse d’accès. Chaque requête envoie alors un message au modèle et récupérer la réponse sous forme de texte. Une application peut alors l’exploiter pour créer un chatbot, générer des résumés ou un assistant intelligent.
Mais avant la finalisation, vous devez réaliser plusieurs séries de tests pour garantir le bon fonctionnement du modèle IA en production. Les voici :
- Le test des réponses API: vérifier que le modèle reçoit correctement les requêtes et donne les réponses adaptées ;
- La mesure de la latence: mesurer le temps de réponse surtout pour les requêtes longue ;
- La vérification des erreurs: évaluer les réponses http, les problèmes d’authentification ou les éventuelles erreurs d’exécution ;
- Le test de requêtes simultanées: analyser le comportement du modèle lorsque de nombreux utilisateurs utilisent le service en même temps ;
- Le contrôle des ressources: surveiller la consommation du GPU, de la mémoire et les variations.
Vous souhaitez passer de votre prototype IA à une solution réellement opérationnelle ? Notre agence web DigitalUnicorn vous accompagne dans le développement, l’intégration des API et la mise en production de votre application.
Optimiser les performances et la latence en production
Pour que votre modèle puisse bénéficier de bonnes performances, c’est-à-dire, être capable de traiter plusieurs milliers de requêtes simultanées avec rapidité et de maintenir une qualité de service constante, vous devez optimiser plusieurs paramètres, comme le choix des GPU, la configuration du moteur d’inférence et la gestion des mémoires.
Choisir l’instance GPU adaptée à vos besoins
La vitesse d’inférence, la vitesse de traitement et le coût d’exploitation dépendent en grande partie de la performance du GPU. Un GPU trop faible pour le modèle peut provoquer des ralentissements ou des problèmes de scalabilité. A l’inverse, un GPU trop puissant peut augmenter inutilement les coûts d’infrastructure.
Avant de choisir, vous devez donc analyser la configuration de votre modèle IA, comme sa taille, le volume de requête, le type de traitement (génération de texte, d’images, reconnaissance vocale), la latence voulue et la mémoire vidéo requise. Par ailleurs, les modèles GPU les plus utilisés dédiés à l’IA sont :
- Les GPU entrée et milieu de gamme, comme NVIDIA T4 ou L4: convient aux modèles de langage SLM légers ;
- Les GPU hauts de gamme, comme NVIDIA A100 ou H100: capable de tourner des modèles plus lourds, maintenir une inférence à haut débit et offrir un temps de latence très faible.
Cependant, il est toujours conseiller de réaliser plusieurs tests de charge pour vraiment vérifier lequel des GPU est vraiment le plus adapté à votre modèle IA.
Mise en place de l’autoscaling pour gérer la charge
Le trafic d’une application d’entreprise peut varier considérablement tout au long de la journée. Pendant les heures de pointe ou lors de campagnes marketing, les requêtes peuvent augmenter brutalement. De ce fait, le temps de réponse peut ralentir si l’infrastructure manque de ressource, tandis que si elle conserve plusieurs instances GPU actives même dans des périodes creuses, les dépenses peuvent augmenter inutilement.
C’est pourquoi l’autoscaling de Baseten est très important, puisqu’il permet d’ajuster automatiquement le nombre d’instances à activer selon la variation de la charge et de la limite de la configuration. Par exemple, vous pouvez faire une mise à l’échelle zéro pour arrêter la consommation d’instance après quelques minutes d’inactivités ou garder une instance active pour éviter le démarrage à froid qui peut ralentir les premières requêtes. A l’inverse, l’infrastructure peut augmenter le nombre d’instances utilisé en fonction de l’accroissement du nombre de requêtes.
Une IA lente peut rapidement faire fuir vos utilisateurs. Confiez votre projet à notre agence IA DigitalUnicorn pour développer une application performante, optimiser les échanges avec vos modèles IA et garantir une expérience utilisateur réactive, même lorsque le trafic augmente.
Vous voulez concrétiser un projet numérique ?
William, notre expert, peut vous aider dès maintenant.
Appelez6le au 06 32 64 24 80 — réponse en moins de 3 minutes, de 8h à 20h.