
 ChatGPT
 Claude
 Mode IA
 Perplexity
 par

Le cloud computing, ou informatique en nuage, désigne l’utilisation de ressources informatiques (serveurs, stockage, bases de données, réseau, logiciels) fournies à distance par un prestataire via internet et facturées selon la consommation réelle. Une entreprise n’achète plus de matériel pour l’héberger dans ses locaux : elle accède à ces ressources à la demande, depuis un navigateur ou une interface de programmation. Cette page de glossaire explique comment fonctionne le cloud, quels modèles et quels services existent, à quoi ils servent concrètement et quelles sont leurs limites.
Définition du cloud computing
Le cloud computing est avant tout un modèle d’exploitation de l’informatique, pas une technologie unique. Le NIST, l’organisme américain de normalisation, en a donné en 2011 une définition devenue une référence : un accès par le réseau, à la demande, à un ensemble partagé de ressources configurables, mises à disposition rapidement et avec un effort de gestion minimal. L’image du nuage vient des schémas réseau, où internet était dessiné sous la forme d’un nuage pour masquer la complexité de ce qui se trouvait derrière.
Le NIST décrit cinq caractéristiques qui distinguent un véritable service cloud d’un simple serveur loué. Le libre-service à la demande permet à l’utilisateur de commander des ressources sans passer par un conseiller. L’accès réseau étendu rend ces ressources disponibles depuis n’importe quel poste connecté. La mutualisation répartit les mêmes équipements entre plusieurs clients. L’élasticité rapide ajuste la capacité en quelques minutes, à la hausse comme à la baisse. Enfin, le service mesuré enregistre la consommation, ce qui permet de facturer uniquement ce qui a été utilisé.
Le mot « cloud » recouvre parfois des réalités différentes selon le contexte. Pour un particulier, il évoque surtout le stockage de photos ou de documents sur un compte en ligne. Pour un service informatique, il désigne un ensemble de ressources, de services et de modèles de facturation qui remplacent tout ou partie de l’infrastructure interne. Il ne faut pas non plus le confondre avec la virtualisation, qui n’est qu’une de ses briques techniques : un parc de machines virtuelles installé dans une salle serveur interne, sans libre-service ni facturation à l’usage, ne constitue pas un cloud au sens du NIST.
Le cloud computing s’est imposé dans les années 2000. Amazon a lancé ses premiers services de stockage et de calcul en 2006 sous la marque AWS, avant d’être rejoint par Microsoft Azure, Google Cloud et, en Europe, par des acteurs comme OVHcloud, Scaleway ou Outscale. Aujourd’hui, la plupart des logiciels d’entreprise, des sites web et des applications mobiles reposent, directement ou non, sur ce type d’infrastructure.
Comment fonctionne le cloud computing ?
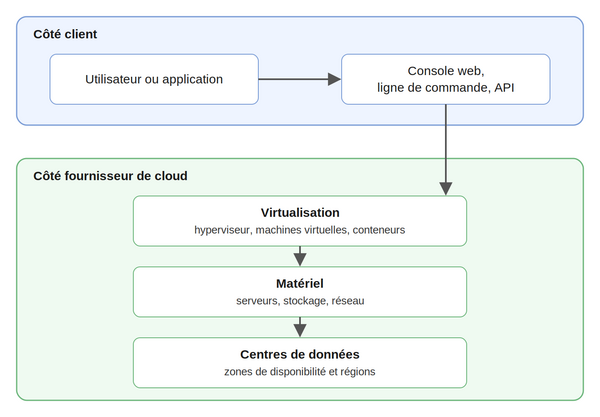
Le fonctionnement du cloud repose sur trois couches complémentaires : des équipements physiques regroupés dans des centres de données, une couche logicielle qui découpe ces équipements en ressources virtuelles, et des interfaces qui permettent aux utilisateurs de les commander et de les piloter. Le fournisseur gère les deux premières couches. Le client, lui, ne voit que la troisième.
L’infrastructure matérielle
Derrière chaque service cloud se trouvent des centres de données : de grands bâtiments remplis de serveurs, de baies de stockage et d’équipements réseau, alimentés par plusieurs sources d’électricité et refroidis en continu. Ces sites sont regroupés en régions géographiques (par exemple Paris, Francfort ou Dublin), elles-mêmes divisées en zones de disponibilité, c’est-à-dire en centres de données indépendants situés à quelques kilomètres les uns des autres.
Cette organisation répond à un objectif précis. Si une zone tombe en panne à cause d’une coupure électrique ou d’un incident technique, une application déployée sur plusieurs zones continue de fonctionner. Le choix de la région a aussi un effet direct sur la latence, c’est-à-dire le temps de réponse perçu par les utilisateurs, et sur la localisation juridique des données.
La virtualisation
La virtualisation est la technique qui permet de partager un même serveur physique entre plusieurs clients. Un logiciel appelé hyperviseur découpe la machine en plusieurs machines virtuelles, chacune disposant de sa part de processeur, de mémoire et de stockage, et chacune isolée des autres. Un client peut ainsi disposer d’un serveur virtuel sans savoir quel équipement l’héberge réellement.
Les conteneurs, popularisés par Docker et orchestrés le plus souvent avec Kubernetes, vont plus loin. Au lieu d’embarquer un système d’exploitation complet, ils regroupent uniquement une application et ses dépendances. Ils démarrent en quelques secondes et utilisent moins de ressources, ce qui explique leur place centrale dans les architectures cloud récentes. Grâce à cette couche d’abstraction, le fournisseur peut déplacer, dupliquer ou redimensionner les ressources sans interrompre les services.
Les interfaces d’accès et API
Pour utiliser ces ressources, le client dispose généralement de trois portes d’entrée. La console web, accessible depuis un navigateur, convient aux opérations ponctuelles. La ligne de commande permet d’automatiser des tâches courantes. Les API (interfaces de programmation) offrent un accès complet, sous forme de requêtes envoyées par un programme, à toutes les fonctions du fournisseur.
Ce sont les API qui rendent possible l’infrastructure as code. Des outils comme Terraform décrivent dans des fichiers texte l’ensemble d’un environnement : serveurs, réseau, bases de données, règles d’accès. Un même fichier peut recréer l’environnement à l’identique en quelques minutes, ce qui limite les erreurs manuelles. Chaque action est identifiée, journalisée et rattachée à un compte, ce qui sert à la fois à la facturation et à la traçabilité.
Les avantages du cloud computing pour les entreprises
Les avantages du cloud tiennent à un changement de logique : l’entreprise cesse de posséder et d’entretenir des équipements pour consommer un service. Ce changement n’est pas toujours favorable, mais il apporte des bénéfices réels dans plusieurs domaines.
Réduction des coûts et optimisation financière
Un parc de serveurs interne suppose un investissement initial important : achat du matériel, aménagement d’une salle, climatisation, onduleurs, licences. Avec le cloud, ces dépenses d’investissement se transforment en dépenses d’exploitation mensuelles, proportionnelles à l’utilisation. Une jeune entreprise peut lancer son produit sans immobiliser de capital, et une structure établie évite de renouveler son matériel tous les quatre ou cinq ans.
Il faut toutefois nuancer. Les coûts du cloud peuvent déraper lorsque des ressources restent allumées sans être utilisées ou lorsque les volumes de données transférés augmentent. D’où l’essor du FinOps, une discipline qui associe équipes techniques et financières pour suivre la consommation, repérer le gaspillage et choisir les bonnes formules d’engagement.
Évolutivité et scalabilité
L’évolutivité, que l’on désigne aussi par le terme anglicisé de scalabilité, correspond à la capacité d’un système à absorber une charge plus importante. Dans le cloud, cette capacité s’ajuste soit en renforçant un serveur existant (mise à l’échelle verticale), soit en multipliant le nombre de serveurs (mise à l’échelle horizontale). Des règles d’autoscaling déclenchent ces ajustements automatiquement selon la demande.
Prenons l’exemple d’un site marchand pendant les soldes ou le Black Friday. Sur une infrastructure classique, il faut dimensionner le matériel pour le pic, quitte à le laisser inutilisé le reste de l’année. Avec un fournisseur cloud, les serveurs supplémentaires sont activés quand le trafic monte, puis supprimés quand il retombe, et seule la période d’utilisation est facturée.
Agilité et rapidité de déploiement
Commander un serveur dans un environnement traditionnel peut prendre plusieurs semaines. Dans le cloud, quelques minutes suffisent pour créer un serveur, une base de données ou un réseau complet. Les équipes de développement peuvent tester une idée, la mettre en ligne et l’abandonner si elle ne convainc pas, sans engager de budget matériel.
Cette rapidité facilite aussi l’expansion géographique. Un éditeur de logiciels qui souhaite servir des clients en Asie ou en Amérique du Nord peut déployer son application dans une région proche d’eux sans ouvrir de site ni signer de contrat d’hébergement local.
Performances et fiabilité
Les grands fournisseurs de services cloud investissent dans des équipements récents, des réseaux à haut débit et des mécanismes de redondance que peu d’entreprises peuvent s’offrir seules. Les engagements de disponibilité, formalisés dans des contrats appelés SLA, atteignent couramment 99,9 % ou plus pour les services les plus utilisés, avec des pénalités financières en cas de manquement.
Les réseaux de diffusion de contenu (CDN) rapprochent par ailleurs les fichiers des utilisateurs en les copiant dans des points de présence répartis dans le monde. Une page web, une vidéo ou une image se charge ainsi plus vite, quel que soit le pays du visiteur. Les performances réelles dépendent néanmoins de la manière dont l’application est conçue : un logiciel mal architecturé ne devient pas plus rapide simplement parce qu’il est hébergé chez un grand acteur.
Sécurité renforcée
Les fournisseurs emploient des équipes entières consacrées à la sécurité, surveillent leurs infrastructures en permanence et obtiennent des certifications reconnues comme ISO 27001. Ils proposent aussi des outils de chiffrement des données, de gestion des identités et de détection des comportements anormaux. Pour une PME qui ne dispose d’aucun spécialiste en interne, ce niveau de protection est souvent supérieur à ce qu’elle pourrait mettre en place seule.
Cette sécurité fonctionne cependant selon un principe de responsabilité partagée. Le fournisseur protège l’infrastructure, c’est-à-dire les bâtiments, les serveurs et le réseau. Le client reste responsable de ses données, de ses accès et de la configuration de ses services. Une grande partie des incidents rapportés dans le cloud provient d’erreurs de paramétrage du côté client, comme un espace de stockage laissé public par inadvertance.
Les différents modèles de déploiement cloud
Le modèle de déploiement décrit à qui appartient l’infrastructure, qui peut l’utiliser et où elle se situe. Quatre configurations reviennent régulièrement, chacune répondant à des besoins différents en matière de contrôle, de coût et de conformité.
Cloud public
Dans un cloud public, l’infrastructure appartient au fournisseur et se trouve partagée entre un grand nombre de clients, chacun restant isolé des autres par la virtualisation. C’est le modèle le plus répandu, celui de AWS, Microsoft Azure, Google Cloud ou OVHcloud. Il offre le plus large choix de services, la plus grande élasticité et une facturation à l’usage.
Ses limites concernent surtout le contrôle : l’entreprise dépend des choix techniques et tarifaires de son fournisseur, et certaines données soumises à des règles strictes peuvent exiger des garanties supplémentaires.
Cloud privé
Un cloud privé est une infrastructure réservée à une seule organisation. Il peut être hébergé dans ses propres locaux ou chez un prestataire qui dédie des équipements à ce client. L’entreprise bénéficie des méthodes du cloud (libre-service, automatisation, mesure de la consommation) tout en gardant la maîtrise de son environnement.
Ce choix concerne souvent les administrations, les établissements financiers ou les acteurs de la santé, dont les contraintes réglementaires ou de confidentialité sont élevées. En contrepartie, le cloud privé demande des compétences internes ou contractuelles solides et un coût de départ plus important, car il se rapproche d’un investissement classique.
Cloud hybride
Le cloud hybride associe un cloud privé, ou une infrastructure sur site, à un ou plusieurs clouds publics, avec des mécanismes de communication entre les deux. Une banque peut par exemple conserver les données de ses clients dans son environnement privé tout en utilisant le cloud public pour les calculs lourds ou les pics de trafic de son application mobile.
Cette approche permet d’avancer progressivement vers le cloud et de répartir les charges selon leur niveau de sensibilité. Elle complique en revanche l’exploitation, car il faut gérer la sécurité, le réseau et la supervision de deux mondes différents.
Multicloud
Le multicloud consiste à utiliser plusieurs fournisseurs de cloud public en parallèle, par exemple un pour l’hébergement des applications et un autre pour l’analyse de données. On le confond souvent avec le cloud hybride, mais les deux notions diffèrent : le premier combine plusieurs clouds publics, le second mélange un environnement privé et un environnement public. Il est tout à fait possible de cumuler les deux.
Les entreprises y recourent pour éviter la dépendance à un seul acteur, choisir le meilleur service pour chaque besoin ou répondre à des exigences de résilience. Le revers est une complexité accrue : outils différents, compétences multiples, factures dispersées et risque de dilution de la politique de sécurité.
Les principaux services de cloud computing
Les services de cloud computing se classent habituellement selon le niveau de responsabilité confié au fournisseur. Plus le service est « haut » dans la pile, moins le client a de choses à administrer, mais moins il dispose de marge de manœuvre sur la configuration.
Infrastructure as a service (IaaS)
L’IaaS, ou infrastructure en tant que service, fournit les briques de base : machines virtuelles, espace de stockage, réseaux, pare-feu. Le client choisit son système d’exploitation, installe ses logiciels et administre l’ensemble au-dessus de la couche matérielle. Amazon EC2, Azure Virtual Machines ou Google Compute Engine en sont des exemples.
Ce modèle convient aux équipes techniques qui veulent garder un contrôle fin sur leur environnement, par exemple pour migrer une application existante sans la réécrire. Il demande en contrepartie des compétences d’administration système et de sécurité.
Platform as a service (PaaS)
Le PaaS fournit une plateforme complète pour développer, tester et exécuter des applications, sans se soucier des serveurs, des mises à jour du système ou de la répartition de charge. Le développeur dépose son code et la plateforme se charge du reste. Heroku, Google App Engine ou Azure App Service appartiennent à cette catégorie.
Les équipes gagnent en productivité, car elles consacrent leur temps à l’application plutôt qu’à l’exploitation. La contrepartie est une certaine dépendance aux langages, aux versions et aux outils pris en charge par la plateforme.
Software as a service (SaaS)
Le SaaS, ou logiciel en tant que service, est le modèle le plus familier : l’utilisateur accède à une application complète depuis son navigateur, sans rien installer, et paie généralement un abonnement par utilisateur. Microsoft 365, Google Workspace, Salesforce ou Slack en sont des exemples connus. Le fournisseur s’occupe de l’hébergement, des mises à jour et de la maintenance.
Pour l’entreprise, l’avantage principal est la mise en service immédiate. Les points de vigilance concernent l’adaptation limitée aux besoins spécifiques, la dépendance à l’éditeur et la gestion des données stockées chez lui.
Function as a service (FaaS)
Le FaaS, souvent appelé informatique sans serveur (serverless), permet d’exécuter de petites portions de code en réponse à un événement : l’arrivée d’un fichier, une requête web, un message dans une file d’attente. Aucun serveur n’est géré par le client, et la facturation se fait à l’exécution, parfois à la milliseconde. AWS Lambda, Azure Functions et Google Cloud Functions en sont les exemples les plus connus.
Ce modèle convient bien aux traitements ponctuels ou irréguliers. Il se prête moins aux applications nécessitant des exécutions longues ou une latence très stable, car le démarrage d’une fonction inactive peut introduire un délai.
Autres services spécialisés
Au-delà de ces quatre grandes familles, les fournisseurs proposent un catalogue étendu de services cloud spécialisés. On y trouve les bases de données managées (DBaaS), qui prennent en charge sauvegardes et mises à jour, le stockage objet pour conserver de grands volumes de fichiers, les services de conteneurs managés, les outils de messagerie et de supervision, ainsi que des services d’analyse de données et d’intelligence artificielle. Chaque offre fonctionne comme une brique que l’on assemble selon les besoins du projet.
Cas d’utilisation concrets du cloud computing
Les usages du cloud se sont multipliés avec la maturité des services. Les cinq cas suivants figurent parmi les plus fréquents dans les entreprises de toutes tailles.
Stockage et sauvegarde de données
Le stockage dans le cloud permet de conserver des documents, des archives ou des sauvegardes sur des serveurs distants, avec une capacité extensible à volonté. Une société peut par exemple copier chaque nuit ses bases de données vers un espace de stockage situé dans une autre région, ce qui protège contre la perte d’un site. Les données sont généralement répliquées sur plusieurs équipements, ce qui réduit fortement le risque de perte accidentelle.
Hébergement d’applications et sites web
Héberger un site web, une boutique en ligne ou une application métier dans le cloud évite d’acheter et d’entretenir des serveurs. Les ressources s’adaptent au trafic, les mises à jour de sécurité du système sont prises en charge selon le modèle choisi, et les visiteurs sont servis depuis la région la plus proche. Des plateformes de commerce en ligne et des éditeurs de logiciels bâtissent ainsi l’essentiel de leur offre sur ces infrastructures.
Analyse de données et intelligence artificielle
L’analyse de grands volumes de données demande une puissance de calcul que peu d’organisations possèdent en interne. Le cloud permet de louer pour quelques heures des centaines de processeurs ou des cartes graphiques spécialisées, puis de les libérer une fois le traitement terminé. Il en va de même pour l’entraînement de modèles d’intelligence artificielle, qui exige des ressources très coûteuses à acquérir. Les fournisseurs proposent aussi des services prêts à l’emploi pour la reconnaissance d’images, la traduction ou l’analyse de texte.
Développement et test d’applications
Les équipes de développement utilisent le cloud pour créer des environnements de test identiques à la production, les lancer à la demande et les supprimer ensuite. Associé à des chaînes d’intégration et de déploiement continus, ce fonctionnement accélère les mises en production et limite les différences entre les environnements, qui sont une cause classique de bogues.
Continuité d’activité et reprise après sinistre
Le plan de reprise d’activité décrit comment relancer les systèmes après un incident majeur : incendie, panne électrique, cyberattaque. Dans le cloud, il est possible de maintenir une copie de l’infrastructure dans une autre région, active en permanence ou démarrée seulement en cas de besoin. Le coût est nettement inférieur à celui d’un second site physique, et les tests de bascule peuvent être réalisés régulièrement sans perturber la production.
Sécurité et souveraineté des données
Confier ses données à un tiers pose des questions de sécurité, mais aussi de droit applicable. La souveraineté des données désigne la capacité d’une organisation à décider où ses informations sont stockées et selon quelles lois elles sont traitées. C’est devenu un critère de choix à part entière dans les projets cloud, en particulier en Europe.
Les enjeux de la conformité réglementaire
En Europe, le règlement général sur la protection des données (RGPD) impose des règles strictes pour le traitement des données personnelles, y compris lorsqu’elles sont hébergées chez un prestataire. Le transfert de ces informations hors de l’Union européenne est encadré, et plusieurs décisions de justice, dont l’arrêt Schrems II de 2020, ont montré que ces transferts pouvaient être remis en cause. Certains secteurs ajoutent leurs propres contraintes : la certification HDS pour les données de santé en France, ou les exigences de la directive NIS2 pour les opérateurs d’infrastructures importantes.
La question de l’extraterritorialité du droit américain, notamment à travers le Cloud Act de 2018, préoccupe aussi de nombreuses organisations. En France, la qualification SecNumCloud, délivrée par l’ANSSI, atteste qu’un fournisseur répond à un référentiel exigeant, qui inclut une immunité face aux lois non européennes. Elle est souvent demandée dans les marchés publics et par les entreprises traitant des informations sensibles. Chaque situation devant être analysée au cas par cas, un avis juridique reste utile pour les projets les plus délicats.
Les bonnes pratiques pour sécuriser son environnement
La sécurité d’un environnement cloud repose d’abord sur une gestion rigoureuse des accès. Il s’agit d’appliquer le principe du moindre privilège (chaque utilisateur ne dispose que des droits nécessaires à sa mission), d’activer l’authentification multifacteur et de supprimer rapidement les comptes inutilisés. Le chiffrement des données, au repos comme en transit, doit être systématique, avec une gestion maîtrisée des clés.
D’autres mesures complètent le dispositif : tenir à jour la journalisation des actions, vérifier régulièrement la configuration des services avec des outils d’audit, sauvegarder les données selon une règle testée et prévoir une clause de réversibilité dans le contrat, afin de pouvoir récupérer ses informations et changer de fournisseur si nécessaire. Le règlement européen sur les données (Data Act), applicable depuis septembre 2025, renforce d’ailleurs les droits des clients en matière de changement de prestataire.
Cloud computing vs hébergement traditionnel
Comparer le cloud à l’hébergement traditionnel aide à comprendre ce que le premier change réellement. Par hébergement traditionnel, on entend l’installation de serveurs dans ses propres locaux, ou la location de serveurs dédiés ou d’un hébergement mutualisé auprès d’un prestataire, avec des ressources fixes et un contrat souvent annuel.
Différences d’infrastructure
Dans un hébergement classique, les ressources sont liées à des machines précises : un serveur dédié a une capacité donnée, que l’on utilise ou non. Dans le cloud, les ressources sont virtualisées, mutualisées et réparties sur de nombreux équipements, ce qui permet d’en modifier la quantité sans changer de matériel. L’infrastructure devient un service que l’on commande, et non un objet que l’on possède.
Gestion et contrôle
Avec un serveur dédié ou sur site, l’entreprise garde un contrôle très fin sur le matériel, le système et l’emplacement physique des machines. Elle assume en retour toute la maintenance, des pièces de rechange aux correctifs de sécurité. Le cloud déplace cette charge vers le fournisseur, selon le modèle de service retenu, mais le client doit accepter une part de dépendance et apprendre à piloter de nouveaux outils.
Flexibilité et accès
Un hébergement traditionnel convient bien aux charges stables et prévisibles, pour lesquelles le coût mensuel fixe reste avantageux. Le cloud se montre plus adapté aux besoins variables, aux projets à durée limitée ou aux équipes dispersées, puisque les ressources sont accessibles depuis n’importe quel lieu connecté. Pour certaines charges constantes et volumineuses, un serveur dédié reste d’ailleurs moins cher qu’un équivalent dans le cloud, ce qui explique que quelques entreprises aient choisi de rapatrier une partie de leurs systèmes.
L’avenir du cloud computing en 2026
En 2026, le cloud computing se transforme sous l’effet de trois mouvements : la demande de puissance liée à l’intelligence artificielle, le rapprochement du calcul des utilisateurs et la pression croissante sur l’énergie et la souveraineté.
L’impact de l’intelligence artificielle
L’intelligence artificielle générative a fait exploser les besoins en processeurs graphiques et en capacité de stockage. Les fournisseurs construisent de nouveaux centres de données et proposent des services dédiés à l’entraînement et à l’exécution de modèles, que les entreprises peuvent utiliser sans investir dans du matériel. L’IA s’intègre aussi dans le cloud lui-même, pour l’aide au développement, la détection d’anomalies ou l’optimisation des coûts. Cette course à la puissance pose cependant des questions de disponibilité des composants et de consommation d’énergie.
L’essor de l’edge computing
L’edge computing consiste à traiter les données au plus près de l’endroit où elles sont produites (usine, magasin, véhicule, objet connecté) plutôt que dans un centre de données éloigné. Il réduit les délais de réponse et limite la quantité de données envoyées sur le réseau. Il ne remplace pas le cloud : les deux se complètent, le traitement immédiat se faisant en périphérie et l’analyse approfondie ou le stockage de long terme restant dans le cloud.
Durabilité et cloud écoresponsable
Les centres de données représentent de l’ordre de 1 à 2 % de la consommation d’électricité mondiale selon les estimations, une part que l’essor de l’IA tend à augmenter. Les fournisseurs communiquent de plus en plus sur l’utilisation d’énergies renouvelables, la récupération de chaleur et des indicateurs comme le PUE, qui mesure l’efficacité énergétique d’un site. Ces chiffres sont souvent déclaratifs, et il est prudent de demander des données détaillées par région. Mutualiser les ressources reste en principe plus sobre que multiplier des serveurs peu utilisés, à condition de supprimer les ressources inutiles.
Comment choisir son fournisseur de cloud ?
Choisir un fournisseur de cloud engage une organisation pour plusieurs années, car migrer des données et des applications d’un prestataire à un autre représente un effort conséquent. La décision gagne donc à reposer sur des critères précis plutôt que sur la notoriété de la marque.
Critères de sélection essentiels
Plusieurs points méritent d’être comparés d’un fournisseur de services à l’autre. La localisation des centres de données et le droit applicable arrivent en premier pour les données réglementées. Viennent ensuite les certifications de sécurité, les engagements de disponibilité du contrat, la qualité du support et les possibilités de réversibilité. La tarification demande une attention particulière : coûts de sortie des données, remises selon l’engagement, facturation du trafic réseau. Il faut enfin regarder la richesse du catalogue, la documentation et la qualité des API, qui conditionnent la facilité d’intégration avec les outils existants.
Évaluation des besoins métier
Avant de comparer les offres, l’entreprise a intérêt à décrire ses besoins réels : quelles applications migrer, quels volumes de données, quel niveau de disponibilité, quelles contraintes réglementaires, quelles compétences en interne. Un site vitrine, un logiciel de gestion et une plateforme d’analyse de données ne demandent pas les mêmes services. Un projet pilote sur une application peu critique permet de tester le fournisseur, de mesurer les coûts réels et de former les équipes avant de déployer à plus grande échelle.
Questions fréquentes sur le cloud computing
Quelle est la différence entre cloud et stockage en ligne ?
Le stockage en ligne est un service parmi d’autres, qui consiste à conserver des fichiers sur des serveurs distants, comme le font Google Drive ou Dropbox. Le cloud computing est un ensemble beaucoup plus large : il inclut le stockage, mais aussi la puissance de calcul, les bases de données, les réseaux, les logiciels et les outils de développement. Autrement dit, le stockage en ligne est l’un des usages du cloud, pas son équivalent.
Le cloud est-il adapté aux petites entreprises ?
Oui, et c’est même l’un de ses principaux atouts. Une petite entreprise accède à des outils de messagerie, de comptabilité, de gestion de la relation client ou d’hébergement sans investissement initial, avec une facturation mensuelle proportionnelle à ses besoins. Les points d’attention restent le suivi des coûts, la maîtrise des accès et le choix d’offres qui laissent la possibilité de récupérer ses données.
Quelles compétences sont nécessaires pour gérer le cloud ?
Cela dépend du modèle de service. Un logiciel SaaS demande surtout des compétences de configuration et de gestion des utilisateurs. Une infrastructure IaaS exige des connaissances en administration système, en réseau, en sécurité et en automatisation. Pour les environnements plus complexes, on rencontre des profils spécialisés : ingénieur cloud, architecte, spécialiste DevOps, responsable FinOps. Les fournisseurs proposent des certifications qui permettent de valider ces compétences.
L’adoption du cloud computing
Le cloud computing a changé la manière dont les organisations consomment l’informatique : ressources à la demande, facturation à l’usage, services accessibles depuis internet et gérés par un fournisseur. Ses avantages (souplesse, rapidité, accès à des technologies avancées) sont réels, mais ils s’accompagnent de contraintes qu’il faut anticiper : maîtrise des coûts, sécurité partagée, conformité réglementaire et dépendance à un prestataire.
Il n’existe pas de modèle unique. Cloud public, privé, hybride ou multicloud, IaaS, PaaS ou SaaS : le bon choix dépend de la nature des données, des compétences disponibles et des objectifs de l’entreprise. Une analyse précise des besoins et un projet pilote bien cadré restent la meilleure manière d’aborder cette transition.