 ChatGPT
 Claude
 Mode IA
 Perplexity

En 2026, dans un monde où les échanges verbaux prennent de plus en plus de place, la transcription audio devient un véritable outil de productivité dans plusieurs domaines. En effet, elle ne se limite plus à la prise de note personnelle, elle répond à un besoin professionnel en matière d’efficacité, de réactivité, de productivité et d’accessibilité. Convertir l’oral en texte est désormais nécessaire pendant les réunions professionnelles, les entretiens, les cours, les podcasts, les discours ou les consultations. Mais, comme la transcription manuelle est difficile et chronophage, les applications dédiées sont maintenant très convoitées.
Grâce à l’essor de l’intelligence artificielle et de la reconnaissance vocale, les utilisateurs peuvent désormais employer une application de transcription audio sur leur smartphone pour transcrire automatiquement des fichiers audio, des conversations ou des réunions, et peuvent même les traduire dans une autre langue. Avec notre agence mobile DigitalUnicorn, découvrez dans cet article comment créer une application de transcription audio, à travers les étapes clés et les fonctionnalités essentielles.
Comprendre le marché de la transcription audio par IA
La création d’une application de transcription audio est une véritable opportunité pour les entreprises et les entrepreneurs, surtout avec des fonctionnalités avancées, comme la transcription en temps réel ou la traduction linguistique. Mais avant tout, vous devez comprendre le marché et les attentes des utilisateurs avant de proposer votre propre service.
L’évolution de la technologie speech-to-text
La technologie speech-to-texte ou reconnaissance vocale automatique de la parole (ASR) est l’ancienne technologie utilisée pour convertir la voix en texte. Elle reposait sur des modèles phonétiques rigides, entraînés pour reconnaître des sons, des syllabes, des mots ou des structures linguistiques. Mais elle restait limitée, car pour fonctionner, elle nécessitait une prononciation claire, un endroit calme et un vocabulaire restreint.
Avec l’arrivée du deep learning (IA) et des modèles de reconnaissance vocale avancés, la transcription s’améliore grandement. Les outils dédiés peuvent ainsi traiter des accents variés, reconnaître plusieurs langues et transcrire des conversations naturelles. Ils comprennent aussi le contexte global, la ponctuation et atteignent des niveaux de précision jamais égalés. Ces progrès ouvrent la voie à plusieurs spécialisations, comme pour les réunions, les notes personnelles, les entretiens ou bien d’autres.
Pourquoi développer sa propre solution de transcription
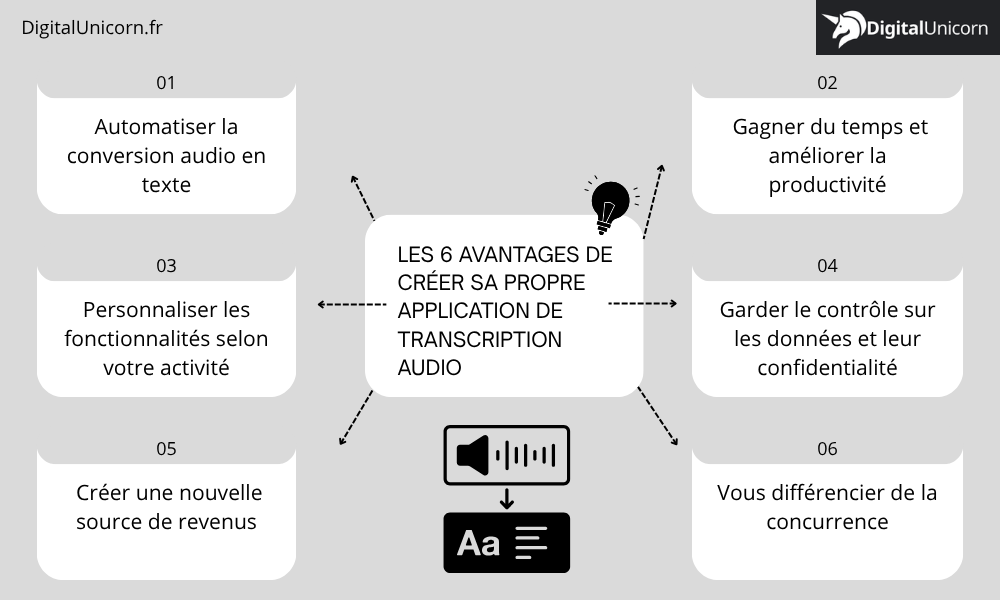
Des géants comme Google Recorder, Otter.ai ou Notta se sont déjà imposés dans le secteur de la transcription automatique et intelligente. Créer sa propre application de transcription présente de nombreux avantages. D’abord, elle permet de répondre à des besoins plus précis que les solutions standards ne peuvent couvrir. Une solution avec un usage ciblé est plus utile qu’une solution générale comportant des fonctionnalités inutiles pour sa cible.
Vous pouvez ainsi personnaliser vos fonctionnalités selon votre public cible, vous spécialiser dans un marché encore inexploité, créer une expérience utilisateur pratique, maîtriser les données et la sécurité, et définir votre propre modèle économique.
Par exemple, une entreprise peut avoir besoin d’une application de transcription pour enregistrer des dizaines de réunions par semaine. Une solution généraliste peut fournir une transcription efficace, mais elle sera limitée en matière de classement de projets, de gestion des accès ou d’intégration avec les outils internes. Une application sur mesure peut répondre à ces besoins, en plus de proposer des fonctionnalités intelligentes en adéquation avec sa spécialité.
Les cas d’usage principaux : réunions, médias et médical
Les exemples de spécialisation sont nombreux. Une telle application ne transcrit pas juste de la voix en texte. Elle peut être spécialisée dans :
- Les réunions et le travail d’entreprise: les équipes peuvent transcrire les réunions pour organiser les idées et les décisions, générer des comptes rendus ou extraire les actions à mener ;
- Les médias, le journalisme et les créateurs de contenu : les journalistes, les podcasteurs et les créateurs de contenu peuvent convertir leurs contenus en texte pour bien rédiger des articles, créer des sous-titres ou rechercher des mots ou des phrases au sein d’heures d’interviews ;
- Le secteur médical: transcrire les consultations en temps réel pour faciliter la rédaction de compte-rendu et alimenter les dossiers patients. Mais il faut prendre en compte les normes strictes de confidentialité, la sécurité des données de santé et le consentement des patients ;
- La relation client : l’appli peut transcrire les appels téléphoniques afin d’identifier les besoins récurrents et d’améliorer les futures conversations ;
- Le juridique: convertir les entretiens, les témoignages ou les échanges pour confirmer les dires, lister les preuves ou vérifier les affirmations.
Le choix du marché influence les fonctionnalités à intégrer, le modèle économique, l’architecture technique, la sécurité, les technologies à utiliser et le coût de développement.
Vous souhaitez vous positionner sur le marché de la transcription audio par IA ? Notre agence IA DigitalUnicorn vous accompagne dans l’analyse de votre projet et le développement d’une application capable de répondre aux nouveaux usages professionnels.
Les étapes clés pour concevoir une application de transcription
De ce fait, le succès d’une application de transcription ne dépend pas seulement de la qualité de l’intelligence artificielle, mais de sa spécialisation, de l’efficacité de son interface et de l’identification des besoins auxquelles répondre.
Définir les fonctionnalités essentielles
Avant le développement, vous devez poser les bases de votre projet, c’est-à-dire, les fonctionnalités qui peuvent répondre aux besoins réels de votre public cible. La création d’un MVP ou Minimum Viable Product qui est la première version de l’application. Il permet de proposer une première expérience de transcription fiable, composée de l’importation de fichiers audio, du lancement d’enregistrements directs, la visualisation du texte transcrit via une conversation ou une réunion, et de l’exportation du résultat dans divers formats.
Un MVP est aussi composé des fonctionnalités de base comme :
- L’enregistrement audio ;
- L’importation des fichiers ;
- La transcription automatique ;
- La transcription en temps réel ;
- La reconnaissance multilingue ;
- L’identification des intervenants ;
- L’édition de texte ;
- L’exportation et le partage ;
- L’historique de transcription.
Après le lancement, vous pouvez enrichir votre application selon les retours des utilisateurs avec des fonctionnalités plus avancées. Cela peut être la génération automatique de résumés, l’extraction de mots-clés, la création de notes structurées ou la traduction de langues. Un module de recherche est aussi très intéressant pour permettre aux utilisateurs de chercher un passage précis dans plusieurs heures d’enregistrement.
Choisir l’architecture technique et le modèle d’IA
L’architecture technique de votre application doit supporter la charge de traitement. Le traitement audio et l’IA sont particulièrement exigeants en ressources de calcul (CPU et GPU). Elle doit alors être composée de plusieurs éléments qui sont déterminants sur la manière dont les composants et les fonctionnalités communiquent entre eux. Voici un exemple d’architecture classique :
- L’interface utilisateur d’une application web ou mobile qui permet d’enregistrer de l’audio, d’importer des fichiers ou consulter les textes transcrits ;
- Le serveur back-end qui gère les comptes utilisateurs, les autorisations, les requêtes et les échanges avec d’autres API ;
- Le stockage des données,où les fichiers audio doivent être conservés dans un espace dédié ;
- Le moteur de reconnaissance vocale qui reçoit le signal audio et le convertit en texte grâce à un modèle d’IA ;
- La base de données qui traite les transcriptions, les informations associées et les paramètres linguistiques ;
- Le système de traitement asynchrone pour gérer les enregistrements volumineux sans bloquer l’interface.
Il existe plusieurs modèles d’intelligence artificielle pour la transcription. Vous pouvez opter pour un modèle open source intégré dans votre application ou vous servir d’une API de reconnaissance vocale proposée par un service tiers. Le choix aura des conséquences sur l’architecture, les coûts et la maintenance.
Concevoir une interface utilisateur intuitive
Pour que votre solution soit efficace, elle doit proposer une interface utilisateur claire, épurée et intuitive afin que les utilisateurs puissent naviguer facilement à travers les fonctionnalités. Pour cela, l’écran principal doit inclure toutes les fonctionnalités essentielles, comme la transcription de fichiers audio, la transcription en temps réel, l’enregistrement audio ou la consultation des anciens fichiers.
Chaque élément doit alors être facilement identifiable, comme le bouton d’enregistrement, la visualisation de l’enregistrement, les menus d’organisation, l’état de la transcription et les textes des contenus. L’accessibilité aussi doit être optimale. Des contrastes suffisants, des typographies claires, une navigation compatible avec les lecteurs d’écran et des icônes facilement identifiables contribuent à faciliter l’utilisation de votre application, même pour les utilisateurs en difficulté.
Vous avez une idée d’application de transcription audio, mais vous ne savez pas par où commencer ? Confiez sa conception à notre agence d’application web DigitalUnicorn pour transformer votre concept en une solution performante, intuitive et évolutive.
Choisir les briques technologiques et les API
Le développement des applications mobiles et web se fait avec des technologies et les API. Selon la complexité de votre solution, vous devez choisir les technologies adaptées qui permettront de transformer des données audio en texte.
Deux grandes approches sont possibles pour intégrer un modèle IA de reconnaissance vocale. La première consiste à intégrer un modèle open source, tandis que la deuxième concerne l’utilisation d’une API Cloud spécialisée.
Utilisation des modèles de reconnaissance vocale open source
Les modèles de reconnaissance vocale open source permettent à votre application de transcrire directement les fichiers et les enregistrements audio sans dépendre d’un fournisseur externe, comme Google Cloud speech-to-texte, mais grâce à un moteur interne. Cette option vous permet de mieux maîtriser les données, d’améliorer la personnalisation, d’être indépendant et de s’affranchir des coûts à l’usage récurrents.
En effet, vous hébergez le modèle dans vos propres serveurs et contrôlez totalement son fonctionnement. Vous devez donc prévoir les ressources nécessaires (CPU, GPU, stockage…). Les modèles les plus appréciés sont Whisper, spécialisé dans la transcription multilingue, Faster-whisper, la version performante de Whisper, et Vosk qui est une bibliothèque de reconnaissance vocale utilisable hors-ligne, idéal pour les applications qui doivent fonctionner en mode offline-first.
Intégration des api cloud : avantages et limites
Pour lancer rapidement un MVP ou par manque d’infrastructure, la meilleure solution est l’intégration des API Cloud. Elles fournissent déjà des modèles d’IA performants et des fonctionnalités avancées sans passer par l’entraînement. De ce fait, les avantages sont nombreux, comme un développement plus rapide, une infrastructure évolutive, des fonctionnalités avancées prêts à l’emploi (transcription en temps réel, diarisation, reconnaissance multilingue…) et une maintenance technique réduite.
Les API les plus utilisées sont Google Cloud speech-to-texte (possibilités de traitement synchrone, asynchrone et en streaming), Azure AI speech qui convient plus aux professionnels et Deepgram, spécialisée dans la transcription des fichiers préenregistrés et des flux audio en temps réel. Mais les coûts peuvent devenir récurrents sur le long terme.
Gérer le traitement du signal et la réduction du bruit
L’efficacité d’une transcription commence bien avant le modèle d’IA. Elle dépend surtout de la qualité du signal audio envoyé au moteur de reconnaissance vocale. En effet, dans les conditions réelles, le micro peut aussi détecter et capter du bruit de fond, des échos ou des interférences. Le traitement du signal et la réduction de bruit doivent alors être intégrés dans votre application en amont. Les bonnes pratiques consistent alors à :
- Normaliser le volume sonore ;
- Réduire le bruit de fond grâce à des algorithmes spécifiques ;
- Détecter les périodes de parole grâce à la technologie VAD (Voice Activity Detection) ;
- Segmenter les enregistrements volumineux pour éviter de couper des mots ou des phrases à la jonction ;
- Améliorer la séparation de voix pour isoler les différentes voix qui parlent simultanément, idéal pour les réunions, les interviews ou les conversations.
Certaines bibliothèques comme FFmpeg, WebRTC ou RNNoise peuvent appliquer toutes ces opérations afin d’éviter les erreurs d’interprétation de texte et de garantir un service fluide et professionnel.
Whisper, API cloud ou moteur de reconnaissance vocale personnalisé : le choix des technologies peut faire toute la différence. Échangez avec notre agence mobile Montpellier DigitalUnicorn pour construire une architecture technique adaptée à vos objectifs et à votre budget.
Développement de la fonctionnalité de conversion voix vers texte
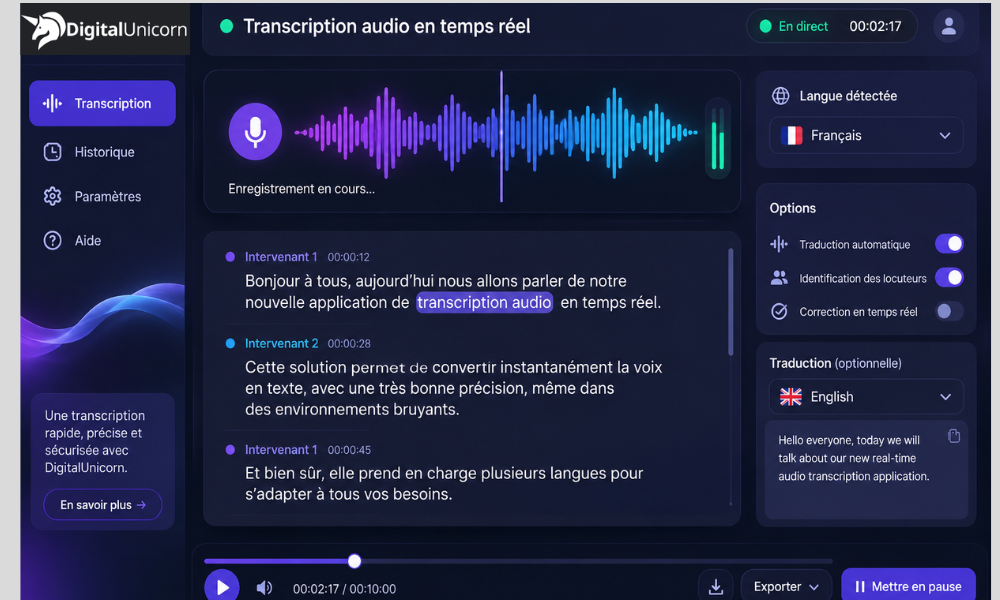
La conversion de voix en texte est la principale fonctionnalité d’une application de transcription audio. Le microphone enregistre les paroles et un modèle IA le convertit en texte en temps réel. Pour cela, vous devez organiser la réception du flux audio, gérer les différentes langues, identifier les intervenants et corriger les erreurs possibles.
Implémentation du moteur de transcription en temps réel
Le moteur de transcription en temps réel permet de convertir directement des paroles en texte venant d’une conversation. Son fonctionnement nécessite plusieurs étapes, dont la capture audio, la transmission des données, le traitement du moteur IA, la restitution des textes et la finalisation.
La difficulté de cette opération réside dans la transcription intermédiaire où certains moteurs peuvent proposer des hypothèses avant de l’ajuster en fonction des nouveaux sons. La latence peut aussi être détectée par l’utilisateur, ce qui donne une impression de mal fonctionnement. Vous devez alors améliorer la performance du moteur IA et de la fluidité de la transcription grâce à un pipeline de streaming efficace avec l’utilisation de Websocket ou des protocoles gRPC.
Gestion des différentes langues et accents
Une application moderne destinée grand public doit avoir la capacité de reconnaître plusieurs langues et de prendre en compte les particularités de prononciation de chaque langue. De plus, les utilisateurs ne doivent pas être obligés de modifier manuellement les paramètres avant chaque enregistrement.
L’intégration des modèles multilingues permet de détecter automatiquement les langues parlées. La gestion des conversations multilingue est aussi indispensable pour les professionnels lors des réunions. Le moteur doit alors prendre en compte les accents régionaux, les tournures locales, les vocabulaires spécialisés, les changements de langue et les noms propres pour une transcription parfaite.
Cependant, il faut savoir qu’aucun moteur ne garantit une reconnaissance parfaite de chaque langue et de ses spécificités. Vous devez juste adapter votre moteur selon les locuteurs présentatifs de votre public cible pour offrir des performances optimales.
Identification automatique des locuteurs
Une conversation qui implique plusieurs personnes nécessite une diarisation vocale ou speaker diarization. En effet, l’utilisateur principal doit savoir lequel de ces interlocuteurs à prononcer telle ou telle phrase au risque d’avoir un texte brouillon et incompréhensible. Cette technologie a pour rôle de segmenter un enregistrement selon les différents participants et d’associer chaque passage à une voix identifiée.
Le moteur doit alors intégrer un système d’analyse des caractéristiques qui peut prendre en compte le changement de voix pour regrouper les segments appartenant à un même intervenant. Dans certains cas, le moteur peut même associer un nom propre à chaque voix au lieu de mettre en place des étiquettes génériques comme intervenant 1 et intervenant 2.
Mise en place d’un système de post-traitement et correction
Enfin, les erreurs sont inévitables même avec l’intelligence artificielle la plus performante. Les plus récurrents sont les problèmes de ponctuation, un nom propre mal interprété et des erreurs d’homophonie, ils peuvent tous modifier le sens d’une phrase. Un système de post-traitement et de correction permet d’améliorer la qualité du texte sans le dénaturer.
Il peut alors intégrer la correction grammaticale et orthographique, la restauration de la ponctuation, la correction des vocabulaires spécifiques, la suppression des répétitions et la mise en forme du contenu. L’intégration d’un modèle LLM permet aussi de générer des résumés, reformuler certains passages ou extraire les informations capitales lors des réunions ou des interviews qui peuvent durer des heures.
Vous souhaitez proposer une transcription rapide, précise et multilingue ? Notre agence mobile Lille DigitalUnicorn développe des fonctionnalités de conversion voix-texte sur mesure, avec traitement en temps réel, identification des locuteurs et correction automatique
Modèles économiques et monétisation
Le dernier pilier de la réussite d’une application de transcription audio est son modèle économique. Il permet de rentabiliser le projet et d’assurer son évolution. Vous devez donc définir un modèle économique adapté aux besoins et aux habitudes de votre public cible, aux fonctionnalités proposées par votre app et aux coûts générés par le traitement audio.
En 2026, plusieurs stratégies de monétisation sont disponibles, comme l’abonnement mensuel, le paiement à la minute, le modèle freemium ou la licence professionnelle. L’objectif est de trouver le bon équilibre entre un tarif suffisamment attractif pour les clients et une marge pour la rentabilité.
Stratégies de tarification pour les logiciels saas
Le modèle SaaS est particulièrement adapté à une application de transcription audio. Il permet aux utilisateurs d’accéder à un service depuis une application mobile ou un site web sans passer par l’installation ou la maintenance du moteur de reconnaissance vocale. Il existe plusieurs modes de facturation selon les besoins et les capacités de votre clientèle, comme :
- La facturation au volume de transcription: elle consiste à facturer le client en fonction du nombre de minutes ou d’heures d’audio traité. Idéal pour les clients occasionnels ;
- L’abonnement mensuel ou annuel: l’utilisateur paie un montant fixe durant un mois ou un an pour accéder à certain volume de transcription et à des fonctionnalités avancées. Cette approche comporte souvent plusieurs plans de tarification (ex : 10 heures/mois pour le plan Pro). Elle convient aux utilisateurs récurrents ;
- La tarification par utilisateur: ce modèle est destiné pour les entreprises avec plusieurs collaborateurs. Le tarif dépend du nombre d’utilisateurs ;
- Les licences professionnelles: l’app propose des offres personnalisées aux entreprises ayant des besoins spécifiques.
Modèle freemium vs abonnement premium
Le modèle freemium est aussi un excellent moyen pour attirer les audiences avant de les convertir plus facilement. Il consiste à proposer une version gratuite de l’application avec des fonctionnalités et une utilisation limitée (30min/mois gratuite) avant de proposer une formule payante pour les utilisateurs qui ont des besoins plus importants.
L’abonnement premium consiste à proposer un essai gratuit de 7 jours, par exemple, avant de limiter l’accès et contraint les utilisateurs à payer pour continuer son utilisation. Il est plutôt destiné pour les entreprises et les professionnels qui souhaitent essayer l’app avant d’investir.
Votre application de transcription doit aussi devenir un projet rentable. Notre agence web DigitalUnicorn vous aide à concevoir une solution évolutive et à intégrer un modèle économique adapté : abonnement SaaS, freemium ou facturation à la minute.
Vous voulez concrétiser un projet numérique ?
William, notre expert, peut vous aider dès maintenant.
Appelez-le au 06 32 64 24 80 — réponse en moins de 3 minutes, de 8h à 20h.