ChatGPT
 Claude
 Mode IA
 Perplexity

En 2026, l’utilisation de l’intelligence artificielle ne se limite plus à l’abonnement à un service Cloud payant accessible depuis un navigateur. Les entreprises et même les particuliers peuvent désormais avoir leur propre solution en interne pour traiter des documents privés et automatiser certaines tâches sans confier leurs données et leurs travaux à des API tierces grâce à AnythingLLM.
C’est une plateforme open source capable de créer un assistant IA autonome, performant et entièrement sécurisé, via des modèles de langage LLM disponible en local ou sur le Cloud. AnythingLLM peut alors gérer une interface de chat, un système de recherche documentaire basé sur le RAG ou même des agents IA qui peuvent manier différents outils. Elle est donc conçue pour s’adapter spécifiquement aux besoins de l’utilisateur selon sa base de données, ses documents et ses ressources.
Mais alors, comment utiliser AnythingLLM ? Comment l’installer ? Et quels sont ses réels avantages ? Pour vous répondre, notre agence IA DigitalUnicorn vous présente le guide complet pour tout savoir sur AnythingLLM, l’IA locale.
Qu’est-ce que AnythingLLM ?
Avant tout, nous allons voir ce qu’est AnythingLLM et poser les bases afin que vous compreniez son utilisation et ses rôles.
Définition et concept de base
AnythingLLM est une application open source dont le rôle est d’exploiter plusieurs fonctionnalités d’intelligence artificielle pour les centraliser dans une même interface. Développée par Mintlabs, elle permet d’importer localement les grands modèles d’IA afin de les rendre facile à accéder et à exploiter, aussi bien pour les particuliers que pour les entreprises. Elle peut alors proposer un assistant conversationnel, des agents IA et des espaces de travail personnels.
En d’autres termes, AnythingLLM est une sorte d’intermédiaire entre un utilisateur, un modèle d’IA et ses propres sources de données. En plus de ses connaissances de base (comme GPT, Gemini ou Claude), elle peut aussi prendre en charge les documents ou les fichiers internes de l’utilisateur pour générer des réponses contextualisées.
Les 3 plus grands atouts d’AnythingLLM sont sa compatibilité avec plusieurs solutions, comme Ollama, OpenAI, Claude et Google Gemini, sa modularité et sa sécurité. Grâce à sa modularité, l’utilisateur peut connecter avec plusieurs modèles d’IA. Par exemple, il peut utiliser Ollama pour la recherche de documents, Claude pour la génération de code et ChatGPT pour des tâches ayant besoin de raisonnement avancé. Enfin, AnythingLLM garantit une sécurité optimale entre vos données et les services tiers même en installant un conteneur Docker.
Pourquoi choisir une solution d’IA locale ?
L’adoption d’une IA locale par rapport à des services Cloud privés permet de répondre à des préoccupations de plus en plus importantes. Les plus récurrentes sont :
- Une confidentialité et une souveraineté totale des données: les bases de données, les documents, les fichiers, les codes et les contrats ne passent pas sur un serveur externe. Vous contrôlez totalement vos données ;
- Une maîtrise parfaite des coûts: en connectant AnythingLLM avec des modèles externes, vous évitez de payer des requêtes aux fournisseurs. Bien évidemment, les dépenses s’orientent plutôt vers le matériel, l’électricité, la maintenance et les ressources informatiques ;
- Un système conçu pour s’adapter parfaitement aux usages professionnels: une IA locale peut être configurée selon les besoins d’une entreprise. Elle peut exploiter des données, comme les procédures internes, les catalogues de produits, les documentations techniques ou les supports de formation, et suivre des instructions ;
- Une indépendance technique: les utilisateurs choisissent les modèles, l’environnement pour l’hébergement, les paramètres et les bases de données à prendre en charge afin que leur IA locale réponde à leurs besoins précis. Toutefois, les ressources doivent être adaptées aux besoins, comme le processeur, la RAM et les cartes graphiques.
Le rôle du RAG (Retrieval Augmented Generation)
Le RAG ou Retrieval Augmented Generation est l’une des fonctionnalités les plus importantes d’une application open source comme AnythingLLM. Il permet aux modèles d’exploiter des sources documentaires sélectionnées plutôt que de se limiter à leurs connaissances de base. Le modèle de langage peut alors apprendre les spécificités métier de votre structure grâce aux mécanismes du RAG composés de :
- L’importation des documents: l’utilisateur ajoute des documents, des fichiers, des images et d’autres sources dans un espace de travail AnythingLLM ;
- L’extraction des contenus: AnythingLLM récupère les informations issues des données importées ;
- Le découpage en segments: les contenus sont divisés en plusieurs fragments, appelés “Chunks” pour faciliter leur traitement ;
- L’indexation: les Chunks sont convertis en vecteurs mathématiques ou « embeddings » et stockés dans une base de données vectorielle ;
- La recherche: quand un utilisateur pose une question, AnythingLLM extrait les chunks les plus pertinents par rapport au contexte du prompt ;
- La génération de réponse: les informations choisies par le LLM sont traitées pour produire une réponse contextualisée.
Vous souhaitez aller au-delà des assistants IA classiques et développer une solution adaptée à votre activité ? Notre agence web DigitalUnicorn vous accompagne dans la conception et le développement de votre assistant IA personnalisé, de l’étude de vos besoins jusqu’à son intégration dans vos outils professionnels.
Fonctionnalités clés de AnythingLLM
AnythingLLM rassemble plusieurs fonctionnalités au sein de son interface pour proposer un véritable environnement de travail. Elle offre plusieurs possibilités aux entreprises comme aux particuliers, de créer un assistant IA capable de répondre à des besoins métiers précis.
Support multi-modèles et intégrations
Pour être plus efficace, AnythingLLM offre une grande flexibilité quant aux choix des modèles d’intelligence artificielle. Elle permet aux utilisateurs de se connecter à plusieurs modèles et de choisir le modèle adapté à chaque utilisation. Dans ce contexte, il existe plusieurs catégories de modèles. D’abord, il y a les modèles locaux, comme :
- Ollama: il permet de télécharger et d’exécuter différents modèles open source sur une infrastructure locale. C’est idéal pour créer un assistant IA sans dépendre d’une API Cloud ;
- LM studio: il dispose d’une interface pour télécharger et gérer des modèles langage en local ;
- KoboldCPP: il peut faire fonctionner des modèles adaptés à la configuration matérielle de l’utilisateur ;
- Le provider intégré: AnythingLLM peut être un modèle exécuté en local sans devoir intégrer un service externe.
Enfin, il y a les modèles Cloud que tout le monde connaît forcément. Ils sont conçus pour les utilisateurs qui recherchent davantage de puissance sans avoir les ressources nécessaires pour la supporter. AnythingLLM prend en charge quelques API Cloud comme :
- OpenAI: permet de se connecter aux modèles GPT via une clé API ;
- Anthropic : donne un accès à Claude qui est expert en codage, en rédaction, en analyse et en matière de traitement de documents longs ;
- Google Gemini: prend en charge la connexion avec Gemini, le modèle IA de Google ;
- Azure OpenAI: permet de connecter les modèles GPT à l’environnement Cloud Microsoft ;
- Mistral AI: offre un accès à un autre modèle de langage via une API.
Gestion des espaces de travail (workspaces)
L’espace de travail, ou aussi le workspaces est aussi un élément central de l’application AnythingLLM. Il permet à l’utilisateur de centraliser son travail et ses données, d’organiser les connaissances et les conversations selon les projets, les équipes et les instructions. Le workspace est donc un genre d’environnement de travail spécifique et étanche, doté de ses propres configurations.
Au lieu de regrouper tous les dossiers et les conversations, l’utilisateur peut créer plusieurs espaces de travail indépendants. Il est également possible d’associer un modèle de langage spécifique à un espace de travail. Cette fonctionnalité permet alors d’organiser le travail et d’éviter le mélange de dossiers et d’informations.
Capacités d’agents et compétences autonomes
L’une des fonctionnalités avancées d’AnythingLLM concerne la création d’agents IA. Ses différences avec les simples assistants IA sont nombreuses. D’abord, l’agent IA ne se contente pas de générer des réponses, contrairement à un assistant. Il peut utiliser des outils pour accomplir certaines tâches. Ces dernières ne sont alors plus limiter à rédiger des textes ou à la réalisation des résumés, mais permettant d’effectuer plusieurs opérations plus complexes grâce à des outils. Voici quelques exemples concrets :
- La recherche documentaire ou RAG search: l’IA peut exploiter les données importées dans le workspace pour trouver des informations pertinentes ;
- La navigation web: l’agent peut chercher des informations en ligne ou consulter des pages web ;
- L’analyse de document: il peut lire, analyser et résumer des documents ;
- La gestion des fichiers: l’agent peut chercher, trier et enregistrer des fichiers ;
- La génération graphique: il peut exploiter des données pour les transformer en représentations graphiques avec les outils nécessaires ;
- L’exécution de tâches plus complexes: interagir avec la base de données, générer des codes contextuels et combler les espaces vides.
La configuration des agents se trouve dans le menu « agent skill » où l’utilisateur peut activer certaines compétences et définir les outils accessibles et les accès aux données. La performance de l’agent IA dépend évidemment du modèle de langage utilisé.
Recherche web et accès au système de fichiers
AnythingLLM propose aussi des accès à d’autres environnements qui peuvent interagir directement avec le modèle IA local. Cette fonctionnalité est utile lorsque les informations recherchées ne se trouvent pas dans les données importées. Il y a :
- La recherche sur le web: AnythingLLM se connecte avec des moteurs de recherche comme Google pour mettre à jour les événements, les informations et les évolutions d’un secteur en particulier.
- L’accès au système de fichiers: le modèle peut interroger, analyser ou manipuler les structures des fichiers locaux afin de traiter certaines questions spécifiques.
Vous souhaitez exploiter les modèles LLM, le RAG et les agents IA pour automatiser vos processus métier ? Faites appel à notre agence de développement DigitalUnicorn pour développer une solution d’intelligence artificielle sur mesure, pensée pour vos utilisateurs et les objectifs de votre entreprise.
Pourquoi utiliser AnythingLLM pour vos documents privés ?
La méthode la plus répondue pour utiliser de l’IA est de recourir aux API Cloud d’OpenAI, de Claude, de Gemini est bien d’autres. Ces services externes peuvent alors accéder à des informations précieuses, comme les contrats, les données financières, les dossiers clients ou les procédures internes.
L’utilisation d’AnythingLLM permet aux entreprises et aux particuliers d’isoler les données sensibles. Cette approche permet ainsi de construire un système autonome interne et de faciliter la recherche documentaire. Mais elle demande des exigences en matière de configuration, de gestion d’accès et de sécurité.
Confidentialité et souveraineté des données
La confidentialité est certainement l’un des meilleurs arguments en faveur d’AnythingLLM. En effet, plutôt que d’utiliser un IA qui traite les requêtes sur une infrastructure externe, elle peut être installée sur un ordinateur ou un serveur local totalement contrôlé par l’utilisateur. L’entreprise peut alors bénéficier d’une meilleure maîtrise des informations et de son environnement de travail.
Toutefois, la souveraineté dépend aussi du modèle de langage connecté à AnythingLLM. Par exemple, l’intégration du modèle d’OpenAI entraîne un traitement de requête par le fournisseur. De ce fait, même si les données sont stockées localement, les informations locales exploitées pour générer une réponse quittent quand même l’infrastructure de l’entreprise.
La meilleure solution est alors d’opter pour un modèle local, d’héberger AnythingLLM sur un serveur privé, de protéger les clés API et les identifiants, de chiffrer les sauvegardes et de sécuriser les communications réseaux.
Fonctionnement hors-ligne et sécurité
AnythingLLM a aussi une capacité à fonctionner en mode hors-ligne à condition de bien configurer son installation sur le serveur local. D’abord, il faut l’associer avec un modèle qui peut marcher localement comme Ollama ou LM studio afin que l’IA puisse donner des réponses sans solliciter un API Cloud. Ensuite, une gestion fine des permissions
C’est un avantage considérable quand les entreprises doivent travailler des informations très confidentielles ou dans des environnements où la connexion internet est affaiblie. En d’autres termes, tout le fonctionnement se passe en interne où AnythingLLM gère l’interface et l’espace de travail et Ollama (ou un modèle IA local) exécute un modèle de langage sur la machine ou le serveur. Toutefois, des fonctionnalités comme la recherche sur le web, les mises à jour, les téléchargements de modèle ou les connexions API qui nécessitent internet ne marchent pas pour le mode hors-ligne.
Comparaison avec les solutions cloud (ChatGPT, Claude)
AnythingLLM fonctionne différemment des autres solutions Cloud, comme ChatGPT ou Claude, mais répond à des besoins plus proches. De ce fait, la différence ne se situe pas sur les réponses générées et les capacités, mais plutôt sur le mode de fonctionnement, le contrôle des données, la configuration et les possibilités d’intégration. Voici les principales différences :
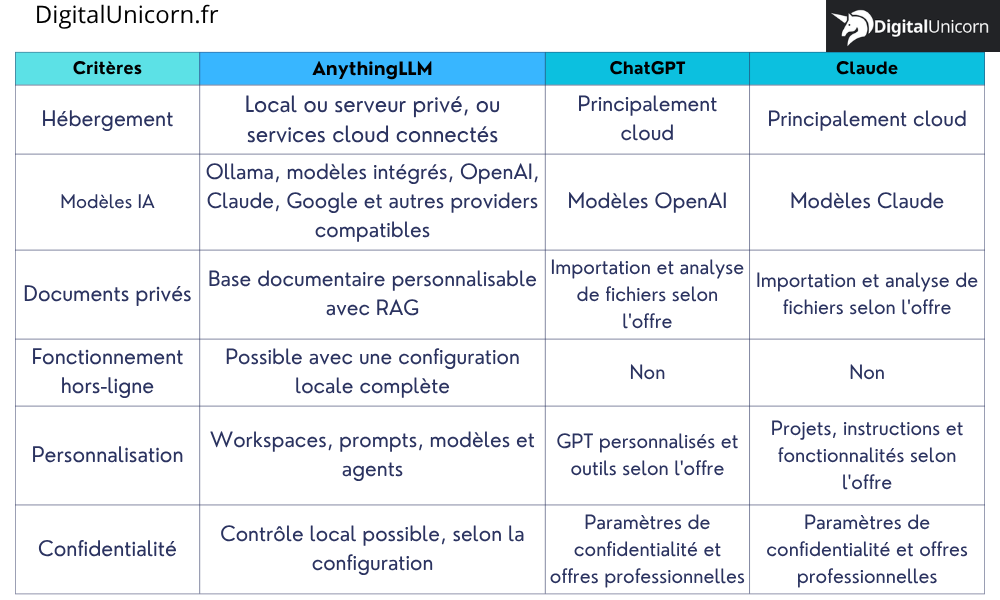
AnythingLLM est donc idéale pour conserver le contrôle de son modèle de langage, garder les informations sensibles sur une infrastructure privée ou créer plusieurs assistants IA. Et les solutions Cloud sont plus pertinentes pour les utilisateurs qui souhaitent utiliser directement un assistant IA sans passe par une installation, une configuration et une ressource matérielle adaptée.
Vos documents professionnels méritent une solution IA fiable et adaptée à vos exigences de confidentialité. Notre agence IA DigitalUnicorn vous aide à concevoir un assistant IA sécurisé, capable d’exploiter vos données internes et de faciliter l’accès à vos connaissances métier.
Guide d’installation et de prise en main
L’installation d’AnythingLLM est assez facile même pour les personnes qui découvrent l’intelligence artificielle pour la première fois. L’application propose une installation sur les ordinateurs individuels et une version docker sur les serveurs locaux et pour les utilisations collaboratives. L’installation sera aussi suivie de la configuration de l’assistant IA pour éviter de la complexité inutile.
Configuration matérielle requise
Les ressources matérielles requises pour utiliser AnythingLLM dépendent du ou des modèles de langage choisis et du mode d’hébergement. De ce fait, les ressources nécessaires pour faire marcher AnythingLLM sont différentes de celles de l’exécution des modèles de langage. Pour les modèles Cloud, AnythingLLM peut les faire tourner sur des machines relativement modiques, mais pour que l’IA tourne en locale, AnythingLLM demande davantage de la mémoire et de puissance de calcul.
Pour vous faire une idée, voici quelques configurations minimum à avoir pour faire marcher AnythingLLM avec les modèles Cloud et une version Docker :
- Mémoire RAM: 4Go minimum recommandées ;
- Processeur: Intel Core i5 / AMD Ryzen 5 récents ou puce Apple Silicon (M1/M2/M3) ;
- Carte graphique: non obligatoire ;
- Mémoire vidéo: dépend du modèle utilisé ;
- Stockage: 10Go pour démarrer et plus pour le stockage de données.
Maintenant, les configurations minimum pour tourner une IA en locale :
- Mémoire RAM: 16Go pour une utilisation de base ;
- Processeur: processeur PC multi-cœurs (8 cœur) ;
- Carte graphique: GPU recommandé (NVIDIA GTX xxxx ou RTX xxxx) ;
- Mémoire vidéo: 8 à 12 Go de VRAM constituent une bonne base sur Windows ;
- Stockage: SSD recommandé (à partir de 128 Go) ;
Installation étape par étape sur Windows, Mac et Linux
Comme nous l’avons vu, AnythingLLM propose une installation sur une version desktop et sur une version serveur. La première est destinée pour les utilisateurs qui souhaitent utiliser l’IA directement sur son ordinateur et le deuxième est conçu pour les entreprises et les développeurs qui veulent déployer un assistant IA sur un serveur privé.
Voici alors les étapes à suivre pour installer AnythingLLM sur un ordinateur (Windows, MacOS et linux) :
- Accéder au site officiel d’AnythingLLM et le télécharger ;
- Choisir l’installation pour utilisateur ;
- Installer AnythingLLM avec une version .exe pour Windows, .dmg pour MacOS et .AppImage pour Linux ;
- Suivre simplement les instructions d’installation ;
- Lancer AnythingLLM depuis le bureau ou dans le menu démarrer.
Le premier démarrage peut prendre quelque temps à cause de la réinitialisation des composants. Cette version Desktop permet de démarrer avec un moteur interne, utilisable même sans installer des modèles locales ou Cloud comme Ollama ou GPT.
Enfin, voici les étapes à suivre pour installer AnythingLLM sur la version serveur, idéal pour les projets professionnels ou l’utilisation collaborative :
D’abord, il faut installer Docker avec les codes appropriés afin de déployer AnythingLLM dans un conteneur isolé, accessible depuis un navigateur web avec l’adresse http://localhost:3001. Ensuite, il faut récupérer l’image officielle et préparer un dossier pour sauvegarder les données de l’application. Enfin, le conteneur peut être lancé.
Première configuration : choisir son moteur LLM
Après l’installation AnythingLLM, celle-ci doit intégrer des modèles IA pour générer des réponses. La qualité des réponses, les ressources nécessaires et la manière dont les données sont traitées dépendent alors du modèle, c’est donc une étape très importante. Le choix du modèle dépend à son tour de vos besoins, de votre budget et de la puissance de votre matériel. La plateforme offre alors plusieurs possibilités :
- Utiliser Ollama pour utiliser une IA en mode local: vous devez d’abord installer Ollama puis le sélectionner dans AnythingLLM ;
- Utiliser le modèle IA intégré dans AnythingLLM, comme Lemonade et llama.cpp pour éviter d’installer à nouveau un autre modèle ;
- Utiliser un modèle IA Cloud (OpenAI, Claude, Gemini) : il faut alors créer une clé API depuis le fournisseur, renseigner cette clé dans AnythingLLM, sélectionner le modèle et vérifier que vous êtes bien connecté.
Ensuite, vous devez choisir l’Embedding Engine qui consiste à sélectionner le moteur pour transformer les textes en vecteur. Il faut savoir qu’il est différent du LLM qui est chargé de générer des réponses. Il permet de retrouver les passages pertinents dans les documents importés. L’option intégrée par défaut (LanceDB ou AnythingLLM Embedder) est déjà suffisante pour démarrer rapidement sans configuration complexe.
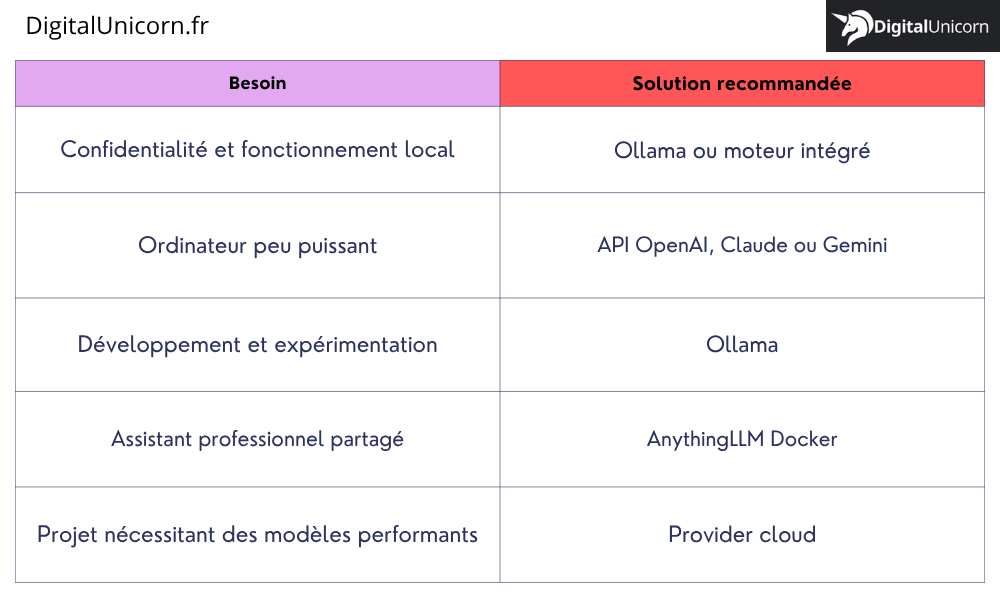
Pour finir, vous continuez sur “Save and Continue” pour finaliser la préparation de votre environnement de travail. Vous pouvez ainsi commencer à utiliser votre IA en local et à créer votre espace de travail.
Vous souhaitez déployer AnythingLLM, connecter vos modèles IA et configurer une architecture performante ? Notre agence d’application web DigitalUnicorn vous accompagne dans le développement, l’intégration et le déploiement de solutions IA adaptées à vos contraintes techniques et à votre budget.