
 ChatGPT
 Claude
 Mode IA
 Perplexity
 par

Le backlog produit, appelé aussi product backlog, est la liste ordonnée de tout ce qu’une équipe prévoit de réaliser pour faire évoluer un produit : fonctionnalités, corrections d’anomalies, chantiers techniques, pistes de recherche. Il constitue la source unique du travail à venir, et le product owner en porte la responsabilité. Ce guide explique ce que contient un backlog, comment le construire, comment hiérarchiser son contenu et comment le garder utile au fil des mois.
Le terme vient de l’anglais et désigne littéralement une réserve de travail en attente. Dans le monde du développement logiciel, il s’est imposé avec Scrum, puis s’est diffusé vers d’autres cadres agiles comme Kanban. Il est devenu une pratique courante du product management, bien au-delà des seuls services informatiques. Découvrez ci-dessous les notions utiles pour comprendre cet outil, depuis sa définition jusqu’aux erreurs les plus fréquentes.
Qu’est-ce qu’un backlog produit ?
Définition et rôle du backlog dans la méthode agile
Un backlog est une liste d’éléments classés par ordre de priorité, chacun décrivant une valeur à livrer aux utilisateurs ou à l’organisation. Il ne s’agit pas d’un cahier des charges figé : le contenu évolue à mesure que le groupe apprend, que les clients expriment de nouveaux besoins et que le marché change. Chaque élément, qu’il s’agisse d’une fonctionnalité ou d’un correctif, reste modifiable tant qu’il n’a pas été pris en charge. Une organisation qui gère plusieurs produits tient en général un backlog distinct pour chacun.
Dans le cadre agile, son rôle consiste à aider les développeurs à savoir quoi construire ensuite, et à offrir aux parties prenantes une vue d’ensemble de ce qui est prévu, de ce qui est en cours et de ce qui a été écarté. Les demandes situées en haut de la pile sont détaillées et prêtes à développer, tandis que celles du bas restent volontairement plus floues.
La différence entre backlog produit et sprint backlog
Le product backlog couvre la totalité du produit et s’étend sur plusieurs mois, parfois davantage. Le sprint backlog, lui, ne contient que la sélection de tickets que l’équipe s’engage à terminer pendant un sprint, c’est-à-dire une itération de une à quatre semaines dans Scrum. Pour le dire autrement, le premier est un réservoir et le second un plan d’action à court terme.
Lors du sprint planning, l’équipe de développement puise dans le sommet du backlog produit, découpe les demandes en tâches et se fixe un but pour la période. Une fois celle-ci démarrée, le sprint backlog ne bouge presque plus, alors que le product backlog continue d’évoluer. Cette distinction évite une confusion fréquente : ajouter des idées au backlog produit n’engage personne à les livrer dans l’immédiat.
Les éléments essentiels à inclure dans votre backlog
Un backlog sain mélange plusieurs natures d’activité. Les ranger dans un même espace donne une image honnête de l’effort réel demandé aux développeurs, au lieu de réserver la visibilité aux seules nouveautés. Quatre familles reviennent presque toujours.
Les user stories : la base de votre développement
La user story décrit un besoin du point de vue de l’utilisateur, selon une formule classique : en tant que (profil), je veux (action) afin de (bénéfice). Par exemple, « en tant que client, je veux enregistrer mon panier afin de finir mon achat plus tard ». Cette formulation ramène la discussion vers l’effet recherché plutôt que vers la solution technique. Chaque story s’accompagne de critères d’acceptation, qui précisent à quelles conditions elle sera considérée comme terminée.
Corrections de bugs et dette technique
Les anomalies détectées en production ont leur place dans le backlog, au même titre que les nouveautés. Un bug bloquant passe devant tout le reste, un défaut mineur peut attendre plusieurs sprints. La dette technique recouvre les raccourcis pris par le passé : code difficile à maintenir, composants obsolètes, tests manquants. Elle ne produit aucun effet visible pour le public, mais elle ralentit chaque évolution ultérieure. L’inscrire dans le backlog permet de la chiffrer, de la comparer aux autres priorités et de lui consacrer du temps de façon délibérée.
Fonctionnalités et améliorations futures
Ce sont les entrées les plus visibles : nouvelles fonctionnalités, refonte d’écrans existants, accélération d’un parcours. Une bonne amélioration se décrit par son effet attendu, par exemple réduire le délai de paiement ou simplifier l’inscription, et non par la méthode employée. Cette façon de formuler laisse aux développeurs la liberté de choisir la solution la plus adaptée.
Acquisition de connaissances et recherche
Certaines lignes ne produisent pas de livrable à proprement parler. Un spike est une tâche limitée dans le temps dont l’objectif est de lever une incertitude. Quelques exemples : tester une technologie, mener des entretiens avec des clients, évaluer la faisabilité d’une intégration. Le résultat attendu est une décision ou des informations, pas une fonction livrée.
Comment construire un backlog produit efficace ?
Il n’existe pas de recette unique pour la création d’un backlog, mais le processus suit généralement quatre étapes, du cadrage initial jusqu’à l’estimation.
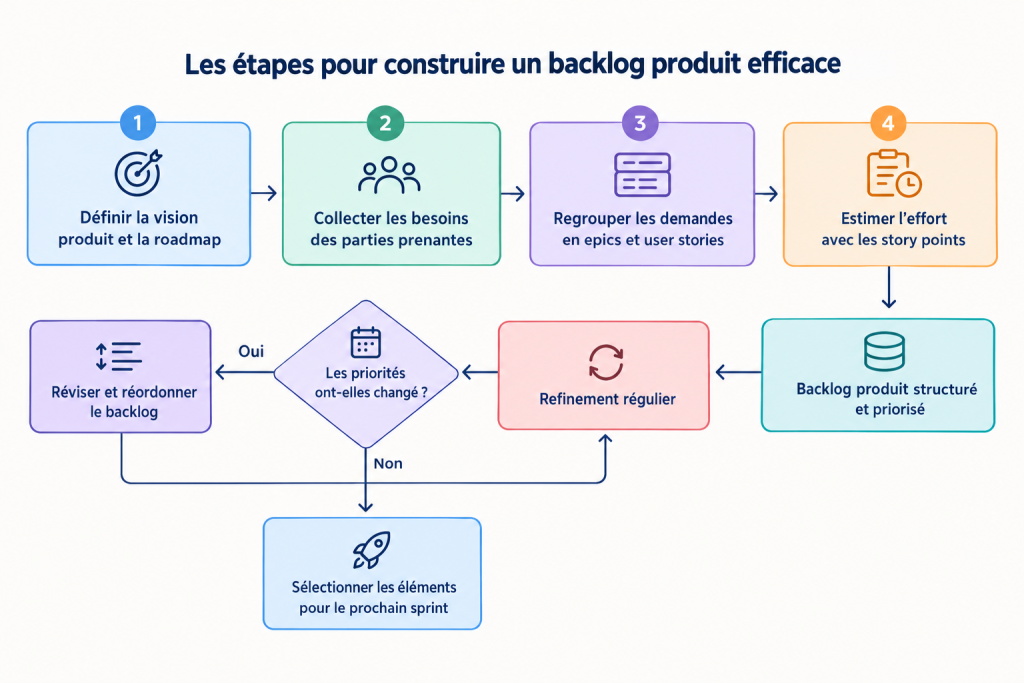
Étape 1 : définir la vision produit et la roadmap
Sans cap, un projet devient vite un fourre-tout. Avant d’ajouter la moindre ligne, les participants formulent la vision du produit : à quels problèmes il répond, pour qui, et quels objectifs mesurables sont visés sur le trimestre ou l’année. La roadmap traduit ensuite cette vision en grandes échéances, sans entrer dans le détail. Elle sert de filtre : une demande qui ne contribue à aucune cible a peu de chances de mériter sa place.
Étape 2 : lister les besoins des parties prenantes
Vient ensuite la collecte des demandes, qu’elles viennent des clients, du support, des équipes commerciales ou des équipes techniques. Entretiens, retours d’usagers, statistiques d’usage et tickets de support constituent des sources complémentaires. À ce stade, l’important est de tout noter sans filtrer ni tenir compte de la faisabilité : le tri vient après, et une demande oubliée coûte souvent plus cher qu’une demande écartée ensuite.
Étape 3 : structurer les éléments avec des epics
Pour organiser des demandes nombreuses, on les regroupe en epics. Une epic est un ensemble de stories qui visent un même but, par exemple « paiement en ligne » ou « espace client ». Grâce à ce regroupement, la lecture se fait par thème et le dialogue devient plus simple avec les parties prenantes, qui raisonnent rarement au niveau de la ligne. Chaque epic se découpe ensuite en unités plus petites, puis en tâches lorsque les développeurs s’apprêtent à les traiter.
Étape 4 : estimer l’effort avec les story points
Les story points mesurent la taille relative d’une entrée plutôt qu’une durée en heures. Le groupe attribue un chiffre, souvent selon une suite proche de Fibonacci (1, 2, 3, 5, 8, 13), en comparant chaque demande à des réalisations passées. Une estimation à 13 points signale qu’il faut découper. Ces chiffres servent à calculer la vélocité, c’est-à-dire le nombre de points terminés par itération, et à prévoir ce que l’équipe peut raisonnablement engager lors de la prochaine itération.
Les stratégies pour prioriser son backlog
Classer les demandes revient à arbitrer entre des attentes concurrentes avec des ressources limitées. Plusieurs techniques existent, chacune avec ses forces et ses limites. Il faut choisir en fonction du contexte : taille de l’organisation, quantité de données disponibles, nature du produit.
La méthode MoSCoW : incontournable en agile
MoSCoW répartit les demandes en quatre catégories : Must have (indispensable), Should have (important), Could have (souhaitable) et Won’t have this time (écarté pour le moment). Son principal atout est la simplicité : elle s’explique en deux minutes et convient aux ateliers avec des parties prenantes peu familières de l’agilité. Sa limite tient à son manque de nuance. Quand la moitié des lignes se retrouve classée en Must have, la méthode ne tranche plus rien.
Le modèle RICE : une approche basée sur les données
RICE attribue à chaque demande un score calculé à partir de quatre critères : Reach (le nombre d’utilisateurs touchés sur une période), Impact (l’effet attendu sur chacun d’eux), Confidence (le degré de confiance dans les estimations) et Effort (la charge de travail nécessaire). La formule est : (Reach × Impact × Confidence) / Effort. Avec 2 000 personnes concernées, un impact moyen valant 1, une confiance de 80 % et un effort de deux personnes-mois, le score atteint 800, soit bien plus qu’une demande émanant d’une poignée de clients pour un effort comparable.
La technique WSJF pour une priorisation mathématique
WSJF, pour Weighted Shortest Job First, provient du cadre SAFe. Le score divise le coût du retard par la durée de réalisation. Le coût du retard additionne la valeur ajoutée pour l’utilisateur, l’urgence liée au temps et la réduction de risque ou l’opportunité créée. Une demande courte à livrer et coûteuse à différer remonte donc dans le classement. Cette méthode oblige à prendre en compte plusieurs critères estimés de façon relative et convient mieux aux structures qui pilotent plusieurs projets en parallèle qu’à un petit collectif.
Les bonnes pratiques pour gérer son backlog au quotidien
Une liste bien construite se dégrade vite sans entretien. Quelques habitudes simples suffisent à la garder exploitable.
L’importance du backlog grooming (ou refinement)
Le grooming, aujourd’hui plutôt appelé refinement dans le guide Scrum, consiste à relire, préciser, découper en tâches et réordonner les lignes du backlog. Beaucoup de groupes y consacrent une session par semaine ou par itération. Les versions antérieures du guide Scrum situaient cet effort à 10 % au maximum de la capacité des développeurs.
Le refinement poursuit trois objectifs : s’assurer que les demandes du sommet sont comprises de tous, retirer ce qui n’a plus de raison d’être, et estimer ce qui n’a pas encore été chiffré.
Impliquer l’équipe produit dans la revue
Le product owner arbitre, mais il ne devrait pas écrire seul. Les développeurs repèrent les dépendances et les risques, les designers apportent la vue côté usager, les testeurs relèvent les cas limites. Inviter tous les profils aux sessions de revue améliore la qualité des stories et réduit les malentendus au moment du sprint planning. Un scrum master ou un product manager peut animer la séance, mais la responsabilité du contenu reste collective côté équipes et individuelle côté responsable du produit.
Maintenir un backlog vivant et transparent
Un backlog est vivant quand il est relu régulièrement : des tickets entrent, d’autres sortent, certains sont reformulés. La transparence suppose qu’il soit accessible à toute personne concernée, avec une priorité lisible et des décisions justifiées. Supprimer sans état d’âme les demandes vieilles de plusieurs mois que personne ne défend est une pratique saine ; si un besoin réel existe, il reviendra. Un backlog de 300 lignes dont la moitié n’a pas été relue depuis un an ne renseigne plus personne.
Ne pas viser la perfection, viser la clarté
Un élément n’a pas besoin d’être parfait pour rejoindre la liste. Une ligne de titre suffit au départ ; le détail s’ajoute quand il approche du sommet. L’essentiel est qu’un développeur comprenne ce qu’on attend de lui, pourquoi, et comment vérifier que c’est fait. Le critère INVEST (Independent, Negotiable, Valuable, Estimable, Small, Testable) fournit une grille de relecture utile pour juger la qualité d’une story.
Les outils indispensables pour la gestion du backlog en 2026
Le marché propose des outils très différents, du tableur partagé au logiciel spécialisé. Le critère décisif reste l’adéquation à la façon de travailler de l’équipe : un tableur qu’elle utilise vraiment vaut mieux qu’un logiciel complet laissé de côté.
Logiciels de gestion de projet agiles
Jira reste la référence dans de nombreuses organisations, avec des tableaux de type Kanban, la gestion des epics, des versions et des rapports de vélocité. Parmi les exemples courants, on trouve Azure DevOps, Linear, Trello, Asana ou ClickUp, plus légères ou plus visuelles selon les cas. Pour un petit projet, un tableau Trello suffit souvent ; dans une entreprise où plusieurs équipes coordonnent des dépendances, un système plus structuré devient nécessaire. Quel que soit le choix, mieux vaut limiter le nombre d’outils afin que le backlog reste à un seul endroit.
Apporter l’intelligence artificielle dans la rédaction de tickets
Les assistants d’IA intégrés aux outils de gestion, ou utilisés à côté, peuvent produire un premier jet de user story, proposer des critères d’acceptation, repérer des doublons ou résumer des retours clients. Ils fonctionnent comme un brouillon : il revient aux humains d’en vérifier la pertinence. Utiliser l’IA pour la mise en forme et la reformulation est un cas d’usage raisonnable ; lui déléguer la décision de priorité l’est beaucoup moins.
Erreurs classiques à éviter lors de la gestion du backlog
Les mêmes écueils reviennent d’une organisation à l’autre. Le premier est le backlog cimetière : des centaines de lignes empilées au fil des ans, dont personne ne sait plus rien. Il décourage les nouveaux venus et masque les vraies priorités. Le deuxième est l’absence de priorisation réelle, quand tout est déclaré urgent. Si tout est prioritaire, rien ne l’est.
Autre erreur fréquente : confondre le backlog avec une boîte à idées où chaque demande est acceptée par principe. Dire non, ou « pas maintenant », fait partie du métier de responsable produit. À l’inverse, certaines organisations écartent systématiquement la dette technique et les corrections, au profit des seules nouvelles fonctionnalités, jusqu’au jour où la vitesse de livraison s’effondre. Enfin, un backlog géré par une seule personne, sans retour du collectif ni des usagers, finit par refléter les hypothèses d’un seul point de vue.
Backlog produit : FAQ
Qui est responsable de la maintenance du backlog ?
Dans Scrum, la responsabilité revient au product owner, qui ordonne le contenu du backlog et s’assure que chacun en comprend le sens. Il peut déléguer la rédaction, mais pas l’arbitrage. Dans les organisations qui n’emploient pas ce rôle, la fonction relève du product management : un product manager ou un responsable produit tient alors le même rôle de pilotage.
Quelle est la taille idéale d’un backlog produit ?
Aucun chiffre ne fait référence. Une règle empirique consiste à détailler assez de lignes pour couvrir deux à trois itérations, soit une vingtaine à une cinquantaine de demandes prêtes, et à garder le reste à un niveau de description grossier. Si la liste dépasse ce qu’une personne peut relire en une heure, un élagage s’impose.
À quelle fréquence faut-il mettre à jour le backlog ?
Au minimum à la fin de chaque itération, et en pratique en continu : un bug urgent, une demande client ou un retour d’utilisation justifie une mise à jour immédiate. Les sessions de refinement servent à une révision plus approfondie, une fois par semaine ou par itération. Un backlog qui n’a pas bougé depuis un mois est le signe d’un outil délaissé.
Le backlog est-il le même en supply chain et en tech ?
Le mot est le même, pas tout à fait le sens. En supply chain, un backlog désigne le volume de commandes reçues mais pas encore livrées ; il se mesure en unités ou en montant et indique le volume de production à venir. Côté logiciel, il s’agit d’une liste de travail à réaliser, sans notion de commande ferme. Les deux usages partagent l’idée d’une file d’attente à écouler, ce qui explique le même nom, mais les indicateurs de pilotage diffèrent.
Transformer votre backlog en levier de croissance
Un backlog produit n’est ni un registre administratif ni un simple fourre-tout : c’est un outil de décision. Relu par l’équipe, ordonné selon des critères explicites et tenu à jour, il aligne la production sur les objectifs du produit et rend visibles les arbitrages.